第 4 章 · v1.1 · 全文呈现
机器的“四肢”:控制与行动
看本章讲解视频第4章 机器的"四肢":控制与行动
4.1 机器人的"反射弧":从空调温控讲透反馈逻辑
4.1.1 夏天的空调:最熟悉的"自动控制系统"
从一个最贴近生活的例子开始——夏天的空调。
用户走进房间,拿起遥控器,设定温度25°C。空调"嘀"了一声,开始工作。压缩机轰鸣,冷风吹出,房间的温度开始下降。当温度接近25°C时,空调自动减小了制冷功率——不是"啪"地一下关掉,而是缓缓地、平滑地降低输出。最终,房间的温度稳定在25°C左右,上下波动不超过0.5°C。这种波动难以被直接感知,但空调内部的传感器和控制器在持续不断地"监测"和"调整",确保温度始终在设定范围内。
这个过程,就是工程控制领域最经典、最基础、也是最重要的控制策略——反馈控制(Feedback Control)。
下面将空调的工作过程拆解为几个关键环节:
设定值(Setpoint):用户设定的25°C,就是系统的"目标"。整个控制系统的目的,就是让"实际值"尽可能地接近"设定值"。
传感器(Sensor):空调内部的温度传感器,实时测量房间的实际温度。它是系统的"眼睛",负责"看"当前状态。
控制器(Controller):空调的控制芯片,接收传感器的读数,计算"设定值"和"实际值"之间的"误差"(Error = 设定值 - 实际值),然后根据这个误差决定"该做什么"。如果误差是正的(实际温度高于设定值),就加大制冷;如果误差是负的(实际温度低于设定值),就减小制冷甚至制热;如果误差接近零,就维持当前状态。
执行器(Actuator):空调的压缩机和风扇,是系统的"手脚",负责执行控制器的指令——增加或减少制冷量。
这四个环节构成了一个完整的闭环:传感器测量 → 控制器计算 → 执行器动作 → 环境变化 → 传感器再次测量 → ……循环往复,直到实际值稳定在设定值附近。131
一个鲜为人知的事实是,日常生活中广泛使用的空调,正是控制理论在日常生活中的典型应用。PID控制带来的舒适无处不在,只是其原理并不为大众所熟知。
4.1.2 PID控制:工业文明的"隐藏基石"
PID控制的全称是比例-积分-微分控制(Proportional-Integral-Derivative Control)。它是工程控制领域最经典、最广泛使用的控制算法,从1922年被发明以来,已经走过了超过100年的历史。22 从冰箱、洗衣机到飞机、火箭,从化工生产到航天飞行,PID控制无处不在。它被称为"工业文明的隐藏基石"——大多数人从未听说过它,但它支撑着我们现代生活的方方面面。
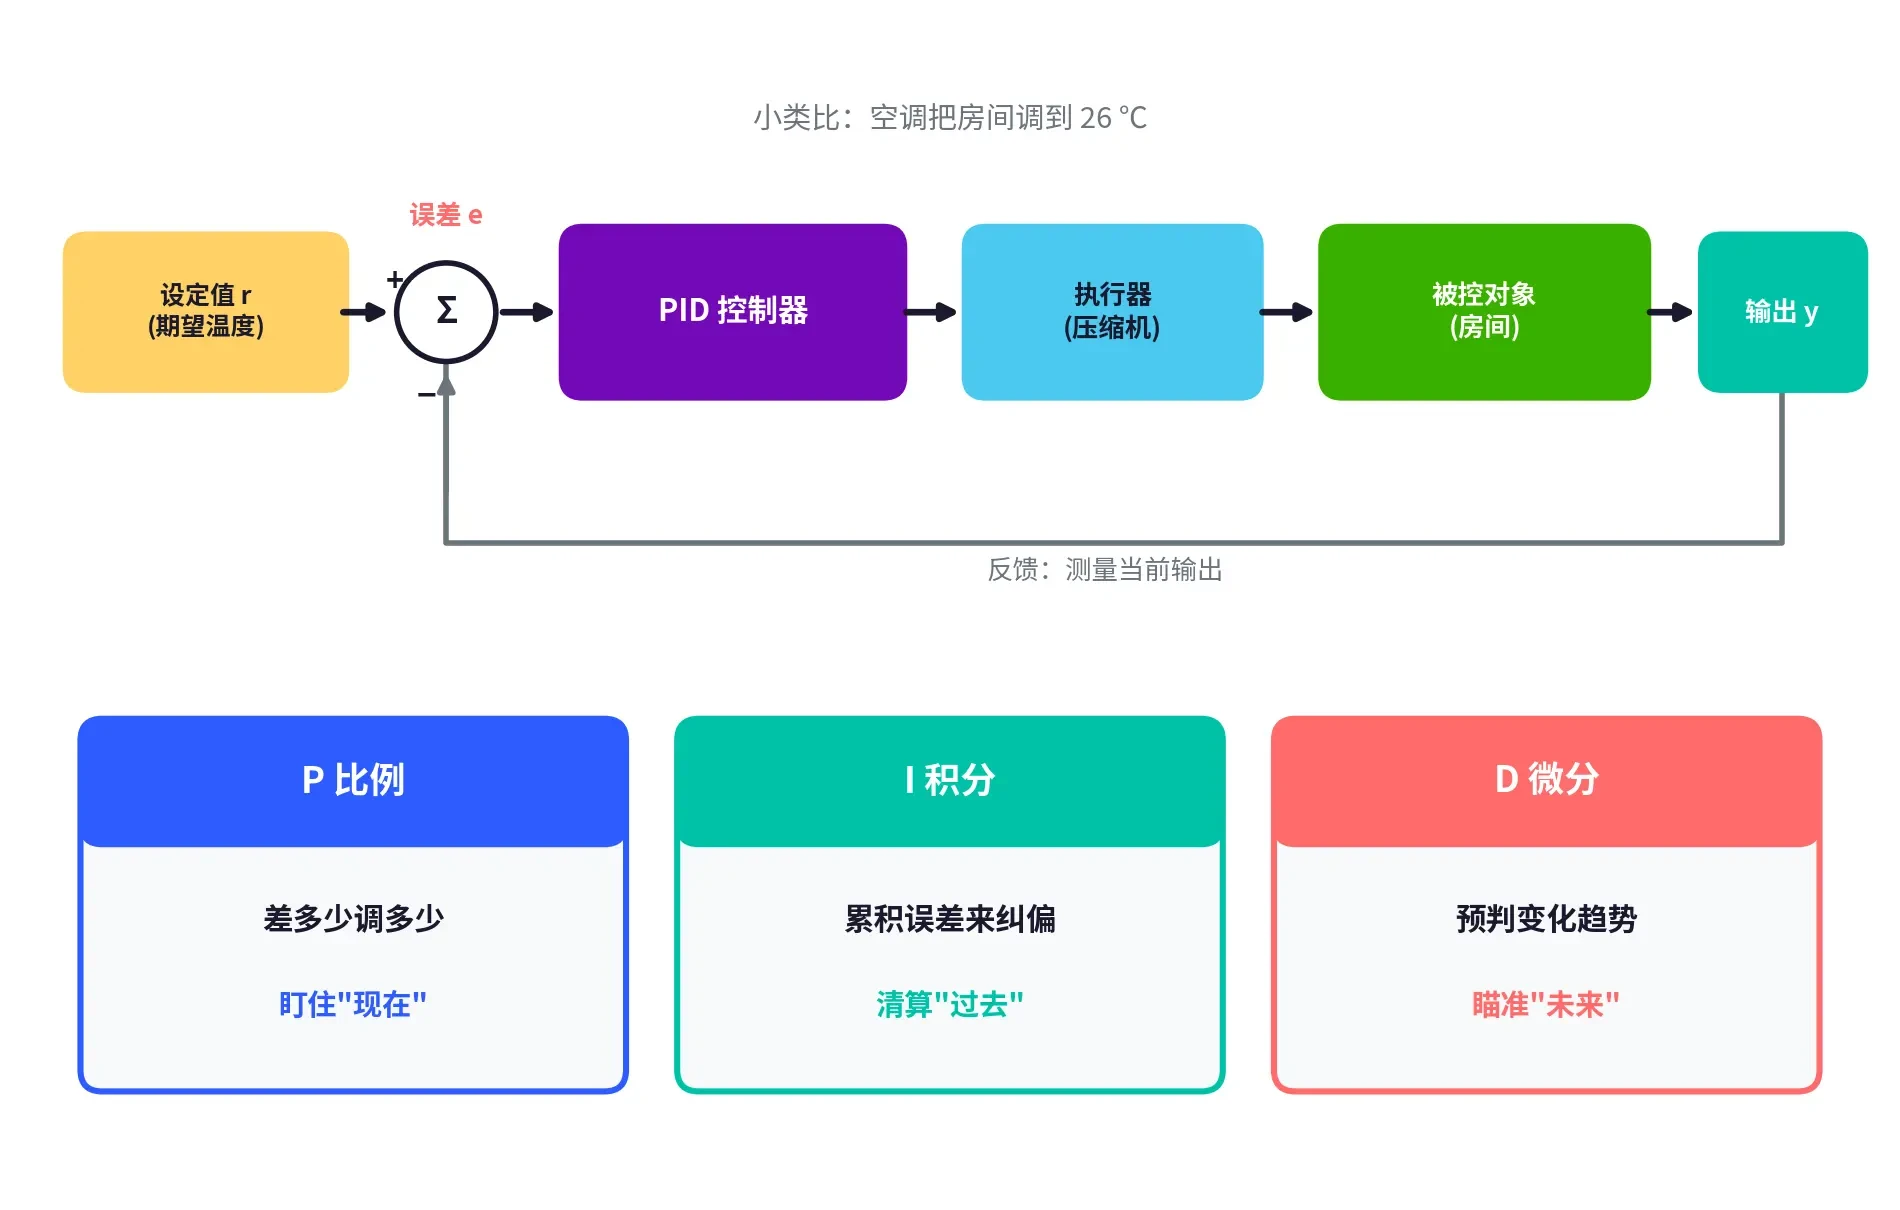
PID控制器的核心思想非常简单:根据"误差"(设定值与实际值之差)的三个"维度"来计算控制输出。下面对各术语作逐一解析:
**
P(比例,Proportional)——"差多少,调多少"
比例控制的逻辑是:误差越大,调节的力度就越大。误差越小,调节的力度就越小。
用空调的例子来说:如果房间温度是30°C,设定值是25°C,误差是5°C。比例控制会说:"误差很大,全力制冷!"如果房间温度降到了26°C,误差是1°C,比例控制会说:"误差变小了,减小制冷力度。"如果房间温度达到了25°C,误差是0,比例控制会说:"误差为零,维持当前状态。"22130
比例控制用一个简单的公式来表达:输出 = Kp × 误差。Kp是"比例增益"——它决定了"对误差的敏感程度"。Kp越大,系统对误差反应越激烈;Kp越小,系统反应越迟缓。
但比例控制有一个固有的问题:它无法完全消除误差。 假设房间温度稳定在25.5°C(误差0.5°C),比例控制会输出一个很小的制冷量。但这个很小的制冷量可能刚好和房间从外部吸收的热量平衡——温度永远降不到25°C,误差永远存在。这个残留的误差叫做"稳态误差"(Steady-state Error)。
I(积分,Integral)——"历史欠账,慢慢补上"
积分控制就是用来解决"稳态误差"问题的。它的逻辑是:把过去的所有误差"累加"起来,如果累加值很大(说明长期以来一直存在误差),就增加调节力度,把这个"历史欠账"慢慢补上。
用空调的例子来说:如果房间温度长时间稳定在25.5°C,比例控制无能为力(误差太小,输出太小)。但积分控制会说:"虽然当前的误差只有0.5°C,但这0.5°C已经持续了好几分钟了,累积起来的'欠账'已经不少了,我再增加一点制冷量,把温度压到25°C。"130131
积分控制用公式表达:输出 = Ki × ∫误差 dt。Ki是"积分增益",它决定了"对历史欠账的敏感程度"。
积分控制虽然能消除稳态误差,但它也带来了新的问题:超调(Overshoot)。当温度从下方接近设定值时,积分项可能已经"积累"了很多,导致控制器输出过大的调节量,使得温度"冲过头"——比如从24.5°C一下子冲到了23°C,然后又要反过来调节。这种"来回震荡"就是积分控制可能带来的副作用。
D(微分,Derivative)——"提前刹车,防止冲过头"
微分控制就是用来解决"超调"问题的。它的逻辑是:观察误差的变化趋势,如果误差在快速减小(说明系统正在快速接近目标),就"提前减小"调节力度,防止"冲过头"。
用空调的例子来说:如果房间温度从28°C快速下降到26°C,微分控制会说:"温度下降得很快,虽然还没达到25°C,但按照这个速度,很快就会降到25°C以下了。我需要提前减小制冷量,防止温度冲过头。"130
微分控制用公式表达:输出 = Kd × d(误差)/dt。Kd是"微分增益",它决定了"对变化趋势的敏感程度"。
把P、I、D三个部分合在一起,就是完整的PID控制器:
输出 = Kp × 误差 + Ki × ∫误差 dt + Kd × d(误差)/dt
这个公式形式较为复杂,但其含义其实并不困难:根据"当前的误差"(P)、"历史的累积误差"(I)和"误差的变化趋势"(D)三个维度,综合决定"应该输出多大的控制量"。
再以生活中的场景为例来加深理解。想象正在驾驶车辆,目标是保持与前车的距离为50米。目测当前距离是80米(误差30米)——P项说"加大油门,缩短距离"。驾驶员踩油门追了一段,距离变成了60米(误差10米)——P项说"减小油门"。但因为追得太猛,距离从60米快速缩小到45米(误差从+10变成-5)——D项说"距离缩得太快了,虽然还没到达50米,但按照这个趋势会超调,提前松油门甚至轻踩刹车"。最后,距离稳定在50米左右,但可能持续停留在52米——I项说"虽然只差2米,但这个误差已经持续了好几分钟了,累积起来不少了,再稍微加点油门消除这个稳态误差"。
可以看出,P、I、D三个项在"开车"这个场景中是如何协同工作的:P负责"大方向"(追上去),D负责"防超调"(别追过头),I负责"消除残余误差"(最后精确对齐)。三者缺一不可。
4.1.3 PID参数整定方法论
PID控制器虽然只有一个公式,但要让它在实际系统中工作得好,需要精心调整三个参数:Kp、Ki、Kd。这个过程叫做"PID调参"(PID Tuning),是控制工程师的核心技能之一。
PID参数整定有一个经典的方法论:"先调P让系统动起来,再加I消除静差,最后D抑制振荡"。141
具体步骤是这样的:
第一步:调P。 先让Ki = 0,Kd = 0,只保留比例项。逐渐增大Kp,观察系统的响应。Kp太小,系统反应迟钝,温度半天降不下来;Kp太大,系统反应过激,温度在设定值附近剧烈震荡。找到一个恰当的Kp——系统能快速响应,但又不至于震荡。
第二步:加I。 在调好Kp的基础上,逐渐增加Ki。Ki太小,稳态误差消除得慢;Ki太大,系统震荡加剧。找到一个恰当的Ki——稳态误差能被消除,但又不引起明显震荡。
第三步:加D。 在调好Kp和Ki的基础上,逐渐增加Kd。Kd太小,超调抑制效果不明显;Kd太大,系统对噪声过于敏感(因为微分项会放大测量噪声)。找到一个恰当的Kd——超调被抑制,但对噪声不敏感。141
调参的过程,本质上是在"响应速度"和"稳定性"之间找到平衡。想要响应快,就需要大的Kp,但这会导致震荡;想要稳定,就需要小的Kp,但这会导致迟缓。好的PID调参,就是在这对矛盾中找到"最优解"。
值得一提的是,很多现代设备(包括空调、冰箱、洗衣机)都内置了"自动调参"功能——设备在首次使用时,会自动运行一个参数辨识过程,通过观察系统的响应来自动调整PID参数。这意味着,许多用户甚至可能不知道PID的存在,就已经在享受它带来的便利了。
4.1.4 从空调到机器人:反馈控制的通用性
PID控制之所以被称为"工业文明的隐藏基石",是因为它几乎适用于所有需要"精确控制"的场景。从空调到机器人,从无人机到自动驾驶汽车,PID控制的原理都是一样的——只是被控制的"物理量"不同。
机械臂定位:目标是让机械臂的末端到达指定位置。传感器(编码器)测量当前位置,控制器计算位置误差,执行器(电机)调整关节角度,直到末端精确到达目标位置。每个关节可能都有独立的PID控制器,多个关节的PID控制器协同工作,完成复杂的空间运动。140
无人机悬停:目标是让无人机稳定在指定高度。传感器(气压计、IMU)测量当前高度和姿态,控制器计算高度误差和姿态误差,执行器(电机)调整四个螺旋桨的转速,产生升力和力矩,维持稳定悬停。四个电机的PID控制器需要精确协调——如果一个电机转速偏高,无人机就会倾斜甚至翻滚。
自动驾驶车道保持:目标是让车辆沿着车道中心线行驶。传感器(摄像头)检测车道线位置,控制器计算车辆偏离车道中心的"横向误差"和"航向误差",执行器(转向电机)调整方向盘角度,使车辆回到车道中心。这个PID控制器的"响应速度"至关重要——如果太慢,车辆可能已经偏离车道太多;如果太快,方向盘会剧烈抖动,乘客会感到不适。
波士顿动力Atlas的平衡控制:Atlas拥有28个主动自由度,每个自由度都有电机驱动。在站立、行走、跳跃、后空翻的过程中,Atlas需要实时调整所有关节的力矩,来维持身体的平衡。这背后是数十个PID控制器的协同网络——有些负责"高度控制"(保持身体高度),有些负责"姿态控制"(保持身体直立),有些负责"位置控制"(保持重心在支撑面内)。这些PID控制器相互耦合、相互影响,构成了一个极其复杂的控制系统。54
所有这些例子都说明了同一个道理:PID控制是反馈逻辑的基石。 无论被控制的是温度、位置、高度还是姿态,无论被控制的对象是空调、机械臂、无人机还是人形机器人,PID控制的原理都是一样的——"测量误差,按比例/积分/微分的方式调整输出"。这个简单的原理,支撑了现代工业文明的半壁江山。
4.2 运动规划:从A点到B点的路径选择
4.2.1 路径规划:避障与最优
PID控制解决的是"如何精确到达目标"的问题。但在到达目标之前,还有一个更基础的问题需要解决:"选择哪条路"?
想象站在食堂门口、想要去窗口打饭的场景。目标很明确——到达打饭窗口。但中间可能有很多人、很多桌子、很多障碍物。不会"直线冲过去"——会不断地观察、调整路线、避开人群。这个过程,就是"路径规划"。
路径规划是具身智能中最基础、也最经典的问题之一。给定一个起点、一个终点,以及环境中的障碍物信息,路径规划算法需要找到一条从起点到终点的可行路径(不碰到障碍物),并且在某些情况下还要最优(最短、最快、最省能量等)。128
在自动驾驶和机器人领域,最常用的路径规划算法包括:
**A*算法(A-star)**是最经典的"最优路径规划"算法。它的核心思想是:在搜索路径时,不仅考虑"从起点到当前位置已经走了多远",还考虑"从当前位置到终点预计还要走多远"。这两个信息的组合,让A*算法能够"高效地"选择搜索方向——优先探索那些"看起来最有希望"的路径,而不是盲目地四处搜索。128137
A算法的"聪明"来自它的评价函数:f(n) = g(n) + h(n)。其中g(n)是从起点到当前节点n的"实际代价"(比如走过的距离),h(n)是从当前节点n到终点的"估计代价"(通常用直线距离来估算)。f(n)就是节点n的"总代价估计"——A总是优先探索f(n)最小的节点。137
A算法的优点是:如果h(n)的估计足够准确,A能保证找到最优路径(在所有可行路径中代价最小的那条)。它的缺点是:需要预先构建"地图"(栅格地图或拓扑地图),在地图很大时搜索效率可能不高。
**RRT算法(Rapidly-exploring Random Tree,快速探索随机树)**是一种"随机采样"的路径规划算法。它的核心思想是:在环境中随机撒点,然后把这些点和已有的"树"连接起来,逐步扩展出一棵覆盖整个环境的"树"。当这棵树"触及"终点时,就找到了一条路径。142
RRT算法的优点是:不需要预先构建地图,能够处理高维、复杂、动态变化的环境。它的缺点是:找到的路径通常不是最优的,而且路径可能很"曲折"、不够平滑。
人工势场法的思路更加直观:把目标点想象成一个"吸引力源"(像磁铁一样吸引机器人),把障碍物想象成"排斥力源"(像同极磁铁一样排斥机器人)。机器人在这些"力"的作用下运动——被目标吸引、被障碍物排斥,最终沿着"合力"的方向到达目标。这种方法的优点是计算简单、实时性好,缺点是容易陷入"局部最优"(比如在两个障碍物之间的"陷阱"里来回震荡)。
4.2.2 轨迹规划:不只是"到哪里",还有"怎么去"
路径规划回答的是"走哪条路"的问题,但它不考虑"什么时候走""走多快""转弯多急"。这些问题属于轨迹规划(Trajectory Planning)的范畴。
路径 = 几何曲线(在哪里转弯、走直线还是弧线)。
轨迹 = 路径 + 时间(什么时候转弯、转多快、速度如何变化)。
生活类比:同样从宿舍到教室,可以"慢悠悠散步"也可以"狂奔"。路径相同(都走同一条路),但轨迹不同(速度、加速度、耗时不同)。139
轨迹规划需要考虑多种约束条件:
速度限制:不能超过道路限速、不能超过车辆的最高速度。
加速度限制:不能急加速(乘客会不适)、不能急刹车(可能追尾)。
曲率限制:转弯不能太急(车辆会侧滑、乘客会晕车)。
加加速度(Jerk)限制:加速度的变化率不能太大(否则乘客会感到"被推"或"被拉")。
能量消耗:在满足以上约束的前提下,尽量节省能源。
一个好的轨迹规划算法,会在所有这些约束条件的"交集"中,找到一条"最优"的轨迹——不是"最快"的(可能不安全),也不是"最慢"的(可能效率低),而是"在安全、舒适、效率之间找到最佳平衡"的。
4.2.3 自动驾驶中的运动规划
在自动驾驶系统中,运动规划通常分为三个层次:139
**行为规划(Behavioral Planning)**是最高层,负责"战略性"的决策:要不要变道?要不要超车?要不要停车让行?这些决策基于对整体交通形势的理解——"前方拥堵,应该变道""右侧车辆速度更快,应该让它先过""前方有行人过马路,应该停车等待"。
**路径规划(Path Planning)**是中层,负责"战术性"的路线选择:在决定了"要变道"之后,具体选择哪条路径来完成变道?在车道内行驶时,是沿着车道中心线走,还是偏向一侧以避开旁边的卡车?
**速度规划(Speed Planning)**是底层,负责"执行性"的速度控制:在每个时间点,车辆应该以什么速度行驶?什么时候加速?什么时候减速?减速的速率应该是多少?
这三个层次相互协调、层层细化:行为规划决定"做什么",路径规划决定"走哪里",速度规划决定"走多快"。
在本书研究团队的YOLO5方案中,运动规划的环节体现在:当系统检测到"关注目标"侵入安全区域时,需要做出行为决策(减速、避让或停车)、规划路径(是否需要变道)、控制速度(减速的速率)。虽然方案A主要是"检测"系统,但其输出结果(关注目标的位置和距离)为后续的运动规划提供了关键输入。
自动驾驶的运动规划还有一个特殊的挑战:动态障碍物。与工厂中固定位置的机械臂不同,自动驾驶汽车需要在"移动的目标"之间穿行。其他车辆、行人、骑行者都在不断运动,他们的未来位置是不确定的。运动规划算法需要"预测"这些动态障碍物的未来轨迹,然后在"预测的未来"中规划路径。
这种"在不确定的未来中规划"的能力,通常通过概率轨迹预测和鲁棒优化来实现。系统不是只预测一条"最可能"的轨迹,而是预测多条"可能"的轨迹,每条轨迹有一个概率。然后,运动规划算法在这些概率轨迹的"交集"中,找到一条"在最坏情况下也安全"的路径。这种方法虽然保守,但能保证安全性。
4.3 带着镣铐跳舞:物理极限内的运动预测与克制
4.3.1 物理世界的"铁律":机器不能违背物理
行动不是"想怎么做就怎么做"。物理世界有一系列"铁律",任何具身智能体都必须遵守——机器人无法违反牛顿定律,正如人类无法违反重力一样。
惯性定律:质量越大的物体,越难改变运动状态。一个满载的大货车(质量40吨)从100km/h刹停,需要约150米的刹车距离;一辆小轿车(质量1.5吨)从同样的速度刹停,只需要约40米。这不是因为大货车的刹车不好,而是因为物理定律——F=ma,质量越大,产生相同的减速度就需要越大的制动力。129
在自动驾驶中,这意味着系统必须"尊重"惯性。在距离前车50米时以120km/h的速度行驶,期望在追尾前"瞬间"停下来——即使算法反应再快,物理定律也不会允许。好的自动驾驶系统会"提前"减速,在到达危险距离之前就把速度降到安全范围。
摩擦定律:轮胎与地面的摩擦力决定了车辆的最大加速度和最大转弯速度。摩擦系数受路面状况影响很大——干燥柏油路面的摩擦系数约为0.7-0.8,潮湿路面约为0.4-0.5,结冰路面仅为0.1-0.2。这意味着在冰面上,车辆的刹车距离是干燥路面的7-8倍!129
这就是为什么自动驾驶系统需要"路面状况感知"——通过摄像头观察路面是否潮湿、是否有积水或结冰,然后相应地调整驾驶策略。在湿滑路面上,系统应该更早刹车、更慢转弯、保持更大的安全距离。
电机极限:电机的最大扭矩和最大转速是"硬天花板"。无论多么急迫地需要加速,电机只能输出其设计范围内的最大扭矩;无论多么需要快速转向,转向电机只能在其最大转速范围内工作。
能量限制:电池容量决定了能跑多远、能做多大功率的动作。Atlas的后空翻之所以不能无限次连续做,是因为电池的电量有限——每次跳跃都需要大量的能量输出。在自动驾驶中,激进的驾驶风格(频繁加速、急刹车)会显著增加能耗,缩短续航里程。
这些物理极限,就是给具身智能体戴上的"镣铐"。好的具身智能系统,不是试图"打破"这些镣铐(这是不可能的),而是学会"戴着镣铐跳舞"——在约束中找到最优解。
4.3.2"鬼探头"场景中的物理约束
回到第2章讨论过的"鬼探头"场景,看看物理约束如何影响行动决策。
当YOLO5检测到"鬼探头"行人时,系统需要在极短的时间内做出一系列决策:
第一,能否在距离内刹停? 这需要计算刹车距离。假设当前车速是60km/h(约16.7m/s),行人距离车头20米,路面干燥(摩擦系数0.7)。根据物理公式,刹车距离约为:
刹车距离 = v² / (2 × μ × g) = (16.7)² / (2 × 0.7 × 9.8) ≈ 20.3米
加上反应时间(系统从检测到行人到开始刹车的延迟,约100-300毫秒)内车辆行驶的距离(1.7-5米),总停车距离约为22-25米。而行人距离只有20米——无法在距离内完全刹停。
第二,能否变道避让? 这需要检查相邻车道是否有车、变道空间是否足够。如果左侧车道有一辆并行的车辆,或者右侧是护栏,变道就不是一个可行的选择。
第三,如果既不能刹停也不能变道? 就需要选择"最小伤害"策略——尽量降低碰撞的严重程度。比如,全力刹车(即使无法完全避免碰撞,也可以降低碰撞速度)、调整方向(尽量让车辆的侧面而不是正面撞击)、做好碰撞准备(收紧安全带、预充气气囊等)。
这就是"带着镣铐跳舞":不是"最优解",而是"约束下的最好解"。系统不能违反物理定律,不能瞬间让车辆停下,不能穿墙而过。它只能在物理允许的范围内,做出最有利于安全的决策。
4.3.3 Sim-to-Real中的物理鸿沟
第5、6章将详细讨论"从虚拟到现实"的问题。但在这里,我们需要先了解一个关键概念:仿真中的物理和真实世界的物理之间存在"鸿沟"。
在仿真环境中训练的控制策略,在迁移到真实世界时,往往会因为物理模型的不精确而出现性能骤降(Performance Degradation)。这种性能衰减的原因包括:129
摩擦模型是近似的:仿真中的摩擦通常用简单的库仑摩擦模型来描述,但真实世界的摩擦受温度、湿度、路面材质、轮胎磨损等多种因素影响,远比模型复杂。
碰撞是离散的:仿真中的碰撞通常是"刚体碰撞"——物体碰撞后瞬间反弹。但真实世界中,碰撞是连续的、有变形的——车辆碰撞时保险杠会变形、吸收能量,而不是像刚体一样弹开。
电机延迟被忽略:仿真中的执行器通常是"瞬时响应"的——控制器发出指令,执行器立即执行。但真实世界的电机从接收指令到产生响应,有10-100毫秒的延迟。
柔性形变未建模:真实世界的物体(如轮胎、悬挂系统、机械臂连杆)都有柔性,受力时会产生形变。仿真中往往把这些物体简化为"刚体",忽略了柔性形变的影响。
这些"简化"在仿真中是可以接受的,甚至是有益的——简化模型计算量小、运行速度快。但当策略从仿真迁移到真实世界时,这些简化就变成了"误差源"。一个在仿真中表现优异的控制策略,在真实世界中可能出现显著的性能下降。
解决这个问题的核心思路是:"不要追求'完美仿真',而应追求'对扰动鲁棒的策略'。" 也就是说,与其试图让仿真无限逼近真实(这是不可能完成的任务),不如让策略对各种"意外"都有准备——即使在仿真和真实之间存在差距,策略也能应对。
具体来说,有几种常用的方法可以缩小Sim-to-Real鸿沟:
域随机化(Domain Randomization):在仿真训练时,故意对物理参数进行随机扰动——摩擦系数每次训练都随机变化、电机延迟每次都不一样、传感器噪声每次都有不同的强度。这样训练出来的策略,对各种"意外"都有准备,因为它"见多识广"。就像一个驾驶员如果在各种路况(晴天、雨天、雪天、泥路)都练习过,其驾驶技术就会更具鲁棒性。
域适应(Domain Adaptation):学习一个"从仿真到真实"的映射函数。先用仿真数据训练策略,然后用少量真实数据来"微调"这个映射函数,使得仿真策略在真实世界中的表现更好。
残差学习(Residual Learning):训练一个"残差模型"来预测"仿真和真实之间的差异"。策略在仿真中运行时,同时运行残差模型来补偿仿真误差,使得策略"感觉"自己是在真实世界中运行。
渐进式迁移(Progressive Migration):从仿真到半仿真(Hardware-in-the-loop,硬件在环)到真实世界,逐步过渡。在半仿真阶段,仿真环境控制真实的执行器(如电机),真实的传感器数据反馈给仿真环境——这样策略可以体验到"真实执行器"的特性,同时仍然在安全的仿真环境中运行。
4.3.4 力控与柔顺:从"硬碰硬"到"软接触"
传统的机器人控制是"位置控制":给定一个目标位置,控制器让机器人精确地到达那个位置。这种控制在工业自动化中非常有效——比如焊接机器人需要在精确的点位进行焊接。
但位置控制有一个致命的问题:它不考虑与环境的接触力。 如果一个位置控制的机器人去抓取一个易碎的鸡蛋,它会"全力以赴"地到达目标位置,结果可能把鸡蛋捏碎。
力控(Force Control)解决了这个问题。力控的目标不是"到达某个位置",而是"施加某个力"。比如,"用5牛顿的力抓住这个鸡蛋"——无论鸡蛋在哪里,只要施加的力是5牛顿,就不会捏碎它。133144
柔顺控制(Compliant Control/Impedance Control)更进一步。它不仅控制力的大小,还控制"力与位移的关系"——就像弹簧一样,当外力作用时,它会产生一个与位移成正比的反作用力。这种"弹性"让机器人能够像人类肌肉一样,在与环境交互时表现出"柔顺性"。133134
生活类比:推门 vs 推婴儿车。推门时,使用的是位置控制——要让门到达"打开"的位置,所以用力推。推婴儿车时,使用的是力控——要让婴儿车以合适的速度移动,所以施加合适的力,而不是把它推到某个精确的位置。
柔顺控制在协作机器人(Cobot)中尤为重要。协作机器人被设计为与人类在同一空间内工作,必须保证在与人类接触时的安全性。通过柔顺控制,当协作机器人碰到人类时,它会"顺从"地退让,而不是"僵硬地"继续执行预定轨迹。133134
波士顿动力Atlas在后空翻落地时的"缓冲"动作,也是柔顺控制的一种表现。Atlas不会"硬邦邦"地砸向地面,而是通过关节的"弹性"来吸收冲击力——就像人类运动员落地时弯曲膝盖来缓冲一样。56
控制系统的"鲁棒性":当模型不准确时怎么办?
PID控制器的一个核心优势在于:它不需要"精确知道"被控对象的模型。只要系统存在"偏差",PID就能产生"修正力"。这种"不依赖精确模型"的特性,被称为鲁棒性(Robustness)。
但在实际工程中,被控对象的特性可能会发生变化——电机的性能会随温度变化,轮胎的摩擦力会随磨损变化,负载的重量会随货物变化。这些变化会让PID控制器的"预设参数"变得不再最优。
自适应PID控制就是为了解决这个问题而诞生的。它的核心思想是:让PID参数根据系统的实时表现自动调整。
以PID控制小车速度为例:刚开始时,小车空载,PID参数调整得当。后来小车装上了货物,变重了,原来的PID参数就"不够力"了——速度响应变慢,超调变大。自适应PID会"检测"到这种变化(通过观察系统的响应曲线),然后自动增大Kp的值,让控制器"更有力"。
自适应PID的实现方式有很多:
增益调度(Gain Scheduling):根据不同的工作条件(如速度、负载、温度),使用不同的PID参数组。就像汽车有不同的"驾驶模式"(经济模式、运动模式、雪地模式),每种模式对应一组不同的控制参数。
模型参考自适应(Model Reference Adaptive Control):定义一个"理想的响应模型",然后实时调整PID参数,使实际系统的响应尽可能接近理想模型。
自整定PID(Self-tuning PID):系统通过参数试探并观察效果,自动找到最优参数组合。其过程类似于音频均衡器的调试——调整某一频段,评估效果,若改善则保留,若劣化则回调。
自适应控制的思想与第3章讲的"强化学习"具有内在的一致性——都是通过"观察效果→调整策略"的闭环来优化性能。区别在于:自适应控制通常基于数学模型和优化算法,而强化学习基于试错和数据驱动。
鲁棒控制的工程意义:
在自动驾驶中,鲁棒性尤为重要。自动驾驶汽车需要应对各种各样的"不确定性":
路面条件的变化(干燥、潮湿、结冰、积雪)
车辆负载的变化(空载、满载、乘客数量变化)
轮胎磨损导致的抓地力变化
风速和风向的变化
一个好的自动驾驶控制系统,必须在这些"不确定性"下都能保持稳定和安全。这就是为什么现代自动驾驶系统不仅仅使用PID,还结合了模型预测控制(MPC,见下文)、自适应控制、甚至强化学习——多层控制策略相互补充,确保系统的鲁棒性。
4.4 PCA闭环的完整拼图:感知→认知→行动的舞蹈
4.4.1 三环相扣:不是流水线,是"共舞"
下面将第2章(感知)、第3章(认知)和第4章(行动)的内容综合在一起,看看PCA闭环是如何完整运转的。
传统的思维方式是"流水线":先感知,再认知,再行动——就像工厂的流水线上,第一个工位拧螺丝,第二个工位装零件,第三个工位质检。这种模型看起来很合理,但它忽略了一个关键事实:感知、认知和行动不是三个独立的步骤,而是一个循环往复、相互塑造的动态系统。
以学骑自行车的例子来说明这一过程。
第一次骑自行车时,车身摇摇晃晃。突然,车身向左倾斜——这是感知(身体感觉到了失衡)。大脑瞬间"意识到"要摔倒了——这是认知。下意识地将车把向右转——这是行动。车身回正了一些,但马上又向右倾斜——新的感知。大脑再次"判断"需要调整——新的认知。再次转动车把——新的行动。如此循环往复,直到找到了那个"平衡点"。
注意这个过程中最关键的一点:行动改变了环境,环境的变化又产生了新的感知,新的感知引发了新的认知,新的认知指导了新的行动。 这不是一条直线,而是一个螺旋上升的圆环。每一次循环,"技能"都在提升——身体在"学习"如何保持平衡。
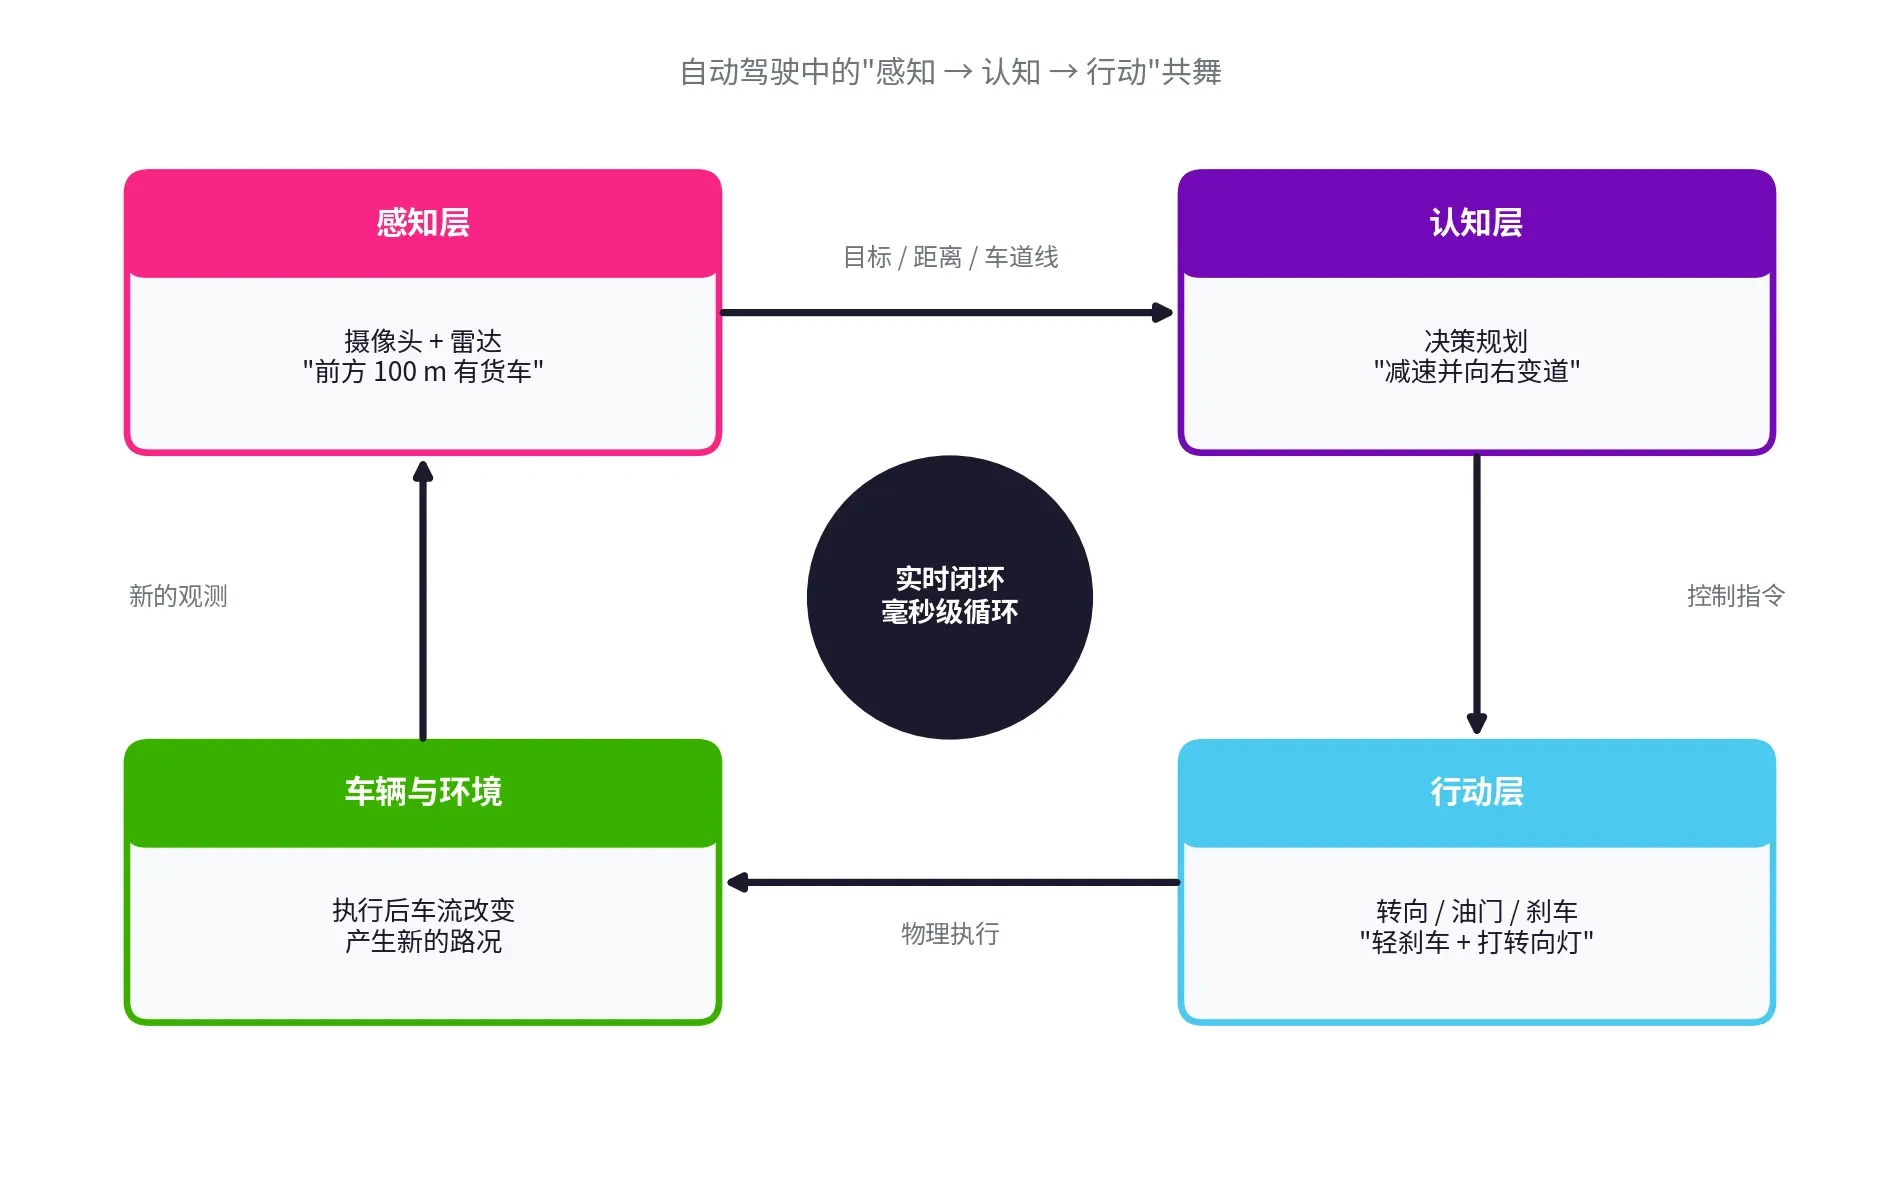
在自动驾驶中,PCA闭环是这样运转的:
**
感知层(第2章):摄像头、激光雷达、毫米波雷达同时工作,实时采集道路环境数据——"前方100米处有一辆货车""右侧车道有一辆小轿车正在靠近""前方50米处有一个行人站在路边"。
认知层(第3章):算法大脑对这些数据进行处理——"货车正在以80km/h的速度行驶,与我车的距离正在缩短,需要保持安全车距""右侧小轿车正在变道,需要减速让它并入""路边的行人没有过马路的迹象,暂时不需要减速,但需要保持警惕"。
行动层(第4章):根据认知结果,系统控制车辆的油门、刹车和方向盘——"适当松开油门,保持当前车道""轻踩刹车,降低车速""双手保持在方向盘上,准备随时制动"。
然后,新的传感器数据不断涌入,新的认知不断更新,新的行动不断调整——闭环持续运转。
这个闭环的核心在于:它不是预先编程好的"如果A则B"的规则列表,而是一个不断学习、不断进化的动态系统。 每一次与环境的交互,都会让这个闭环变得更加"聪明"。
4.4.2 延迟:闭环的"隐形杀手"
PCA闭环虽然高效,但它有一个致命的弱点:延迟。
从"感知"到"认知"到"行动",每一个环节都需要时间。这些时间虽然以毫秒计算,但在高速行驶的场景中,毫秒之差可能就是生死之别。132136
感知延迟:传感器采集数据需要时间。摄像头以30fps工作,每帧的曝光时间约33毫秒;激光雷达旋转一圈需要100毫秒;毫米波雷达的扫描周期约50毫秒。这些延迟意味着,系统"看到"的永远是"几十毫秒之前"的世界。
计算延迟:算法处理数据需要时间。目标检测、轨迹预测、路径规划、控制指令生成——这些计算加起来,可能需要几十到几百毫秒。在复杂的自动驾驶系统中,端到端的计算延迟通常在50-300毫秒之间。138
执行延迟:执行器响应指令需要时间。电机的电磁响应约10毫秒,液压系统的响应约50-100毫秒,机械传动的响应约20-50毫秒。132
总延迟 = 感知延迟 + 计算延迟 + 执行延迟,在自动驾驶系统中,总延迟通常在100-500毫秒之间。132136
下面做一个计算:如果车辆以120km/h(33.3m/s)的速度行驶,每100毫秒的延迟意味着车辆行驶了3.3米。也就是说,当系统"看到"前方有危险并开始制动时,车辆已经"盲开"了3.3米。如果总延迟是300毫秒,这个距离就是10米——这可能是"避免碰撞"和"发生碰撞"之间的关键差距。136
这就是为什么自动驾驶系统对实时性有极其苛刻的要求。为了降低延迟,工程师们采取了各种措施:136139
边缘计算:把计算任务放在车载计算平台上,而不是上传到云端。边缘计算的端到端延迟可以做到5-15毫秒,而云端计算即使在5G网络下也需要50-500毫秒。
任务优先级调度:确保延迟敏感的感知和控制任务优先获得计算资源,而地图更新、日志记录等非关键任务在空闲时段执行。
模型轻量化:通过知识蒸馏、模型剪枝、量化等技术,减小模型的计算量,加快推理速度。
硬件加速:使用专用的AI芯片(如NVIDIA的GPU、Mobileye的EyeQ芯片、华为的昇腾芯片)来加速神经网络推理。
4.4.3 从PCA到PCAP:加入"预测"的进化闭环
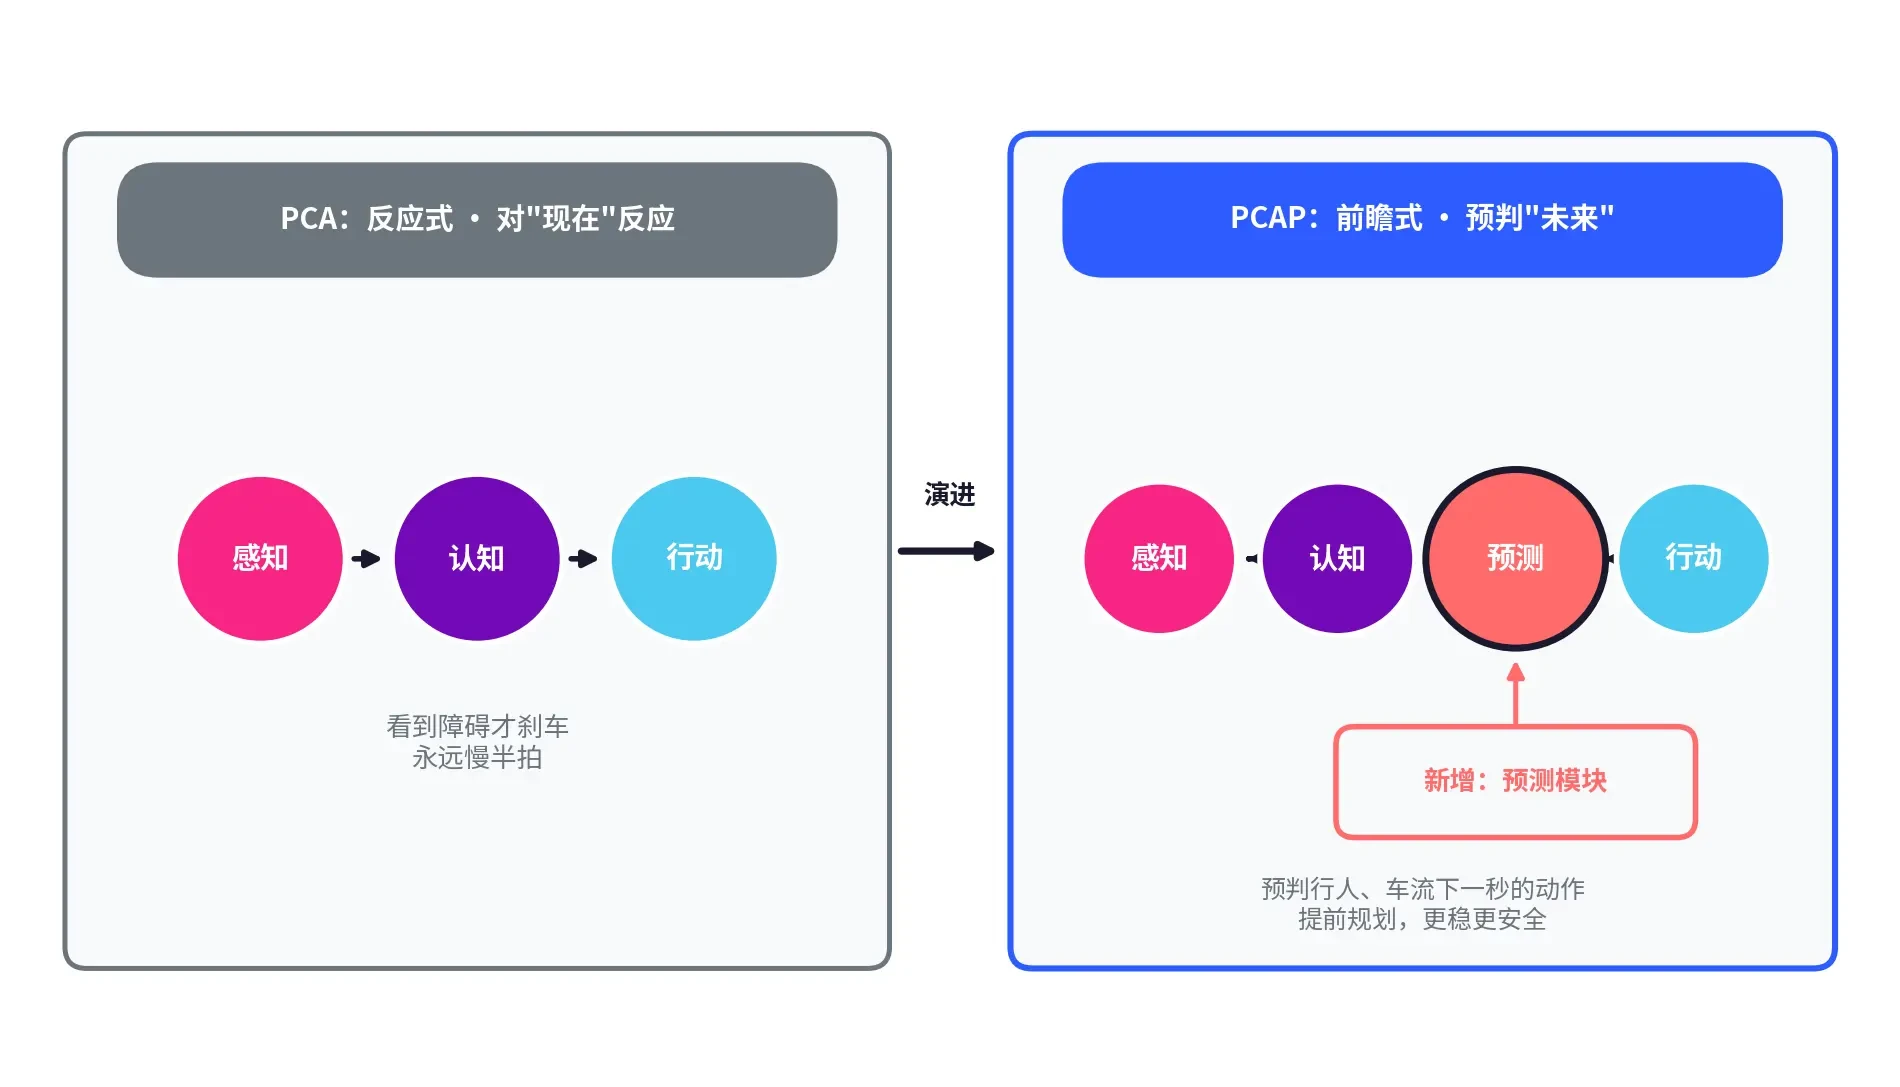
传统的PCA闭环是:感知 → 认知 → 行动。这个闭环是"反应式"的——系统对当前的状态做出反应。
但正如第3章所讨论的世界模型所示,真正智能的系统应该是"前瞻式"的——它不仅对"现在"做出反应,还能对"未来"做出预判。
**
这就是PCAP闭环(Prediction-Perception-Cognition-Action Loop)——在传统的PCA闭环前面,加入一个"预测"环节。
预测(Prediction):基于当前状态和历史数据,预测未来可能发生的事情。"前车正在减速,预测它可能在5秒后停下""右侧车辆打开了转向灯,预测它可能要变道""前方路口绿灯已经亮了20秒,预测它可能即将变红"。
感知(Perception):实时采集环境数据,验证预测的准确性。
认知(Cognition):结合预测和感知,做出更明智的决策。
行动(Action):执行决策。
PCAP闭环的核心优势在于:"预测"让系统"提前准备",而不是"被动响应"。 学术界常用"资深驾驶员"(experienced driver)隐喻来说明这一点:资深驾驶员的价值不在于"反应快"(机器的反应比人类快得多),而在于"想得远"——在危险发生之前,就已经做好了准备。38
这种"前瞻性"的能力,正是世界模型所要赋予具身智能系统的。从PCA到PCAP的进化,标志着具身智能从"反应式"向"前瞻式"的跃迁。
值得注意的是,PCAP闭环中的"预测"环节,不仅依赖于世界模型,还依赖于对其他智能体行为的理解。在自动驾驶中,其他车辆、行人、骑行者都是"有自主决策能力"的智能体。他们的行为不是纯物理的(像球一样可以被精确预测),而是受到他们自己的意图、情绪、习惯的影响。预测一个"有自主意识的智能体"的行为,比预测一个"无生命的物体"要困难得多。
这就是为什么自动驾驶中的"预测"不仅是一个物理问题,还是一个认知问题——需要"理解"其他驾驶员的"意图"。比如,当前车打了左转向灯,需要"理解"它的意图是"要变道";当行人站在路边面朝马路,需要"理解"他可能"要过马路"。这种"理解其他智能体"的能力,有时被称为"心智理论"(Theory of Mind)——即理解"他人有信念、欲望和意图"。人类在社交互动中自然而然地使用这种能力,但机器要做到这一点,仍然是一个开放的研究挑战。
在PCA闭环的完整拼图中,我们还可以看到一个更深层的结构:嵌套的闭环。大的PCA闭环(感知→认知→行动)内部,嵌套着许多小的闭环。比如,在"行动"环节中,PID控制本身就是一个闭环(传感器测量→控制器计算→执行器动作→环境变化→传感器测量)。在"感知"环节中,摄像头的自动曝光也是一个闭环(测量亮度→调整曝光参数→再次测量)。这些"嵌套的闭环"共同构成了具身智能系统的"生命体征"——就像人体中有循环系统、呼吸系统、神经系统等多个相互嵌套的生理闭环一样。
模型预测控制(MPC):"预见未来"的控制方法
PID控制器是一种"反应式"的控制器——它根据"当前的误差"来决定"当前的控制量"。这种"反应式"方法简单有效,但有一个根本的局限:它无法"预见未来"。
想象一下驾驶场景:前方有一个弯道。PID控制器会"到了弯道才转弯"——根据当前的位置偏差来调整方向盘。但人类驾驶员会"提前减速、提前转向"——因为人类能够"预见"弯道的存在,并提前做出调整。
模型预测控制(Model Predictive Control, MPC)就是为了让机器也能"预见未来"。
MPC的工作方式可概括如下:
预测:利用系统的动力学模型,预测未来一段时间内(比如未来3秒)系统在不同控制输入下的行为轨迹。
优化:在所有可能的控制序列中,找到使"代价函数"最小(如轨迹偏差最小、能耗最低、舒适性最好)的最优控制序列。
执行:只执行最优序列的"第一步"控制。
重复:获得新的状态反馈后,重新进行预测和优化。
这个过程就像下棋:不仅考虑"这一步"怎么走最好,还考虑"走了这一步之后,对方可能怎么回应,再怎么应对"。只不过MPC"下棋"的对象不是对手,而是系统的动力学模型。
MPC在自动驾驶中的应用:
MPC是现代自动驾驶控制系统的核心算法之一。它特别适合处理以下场景:
避障:前方突然出现障碍物,MPC可以在短时间内规划出最优的避让轨迹(考虑车辆的动力学约束,如最大转向角、最大加速度)。
跟车巡航:根据前车的速度和距离,MPC可以规划出最平稳、最节能的加减速策略。
紧急制动:在碰撞不可避免时,MPC可以规划出"最小伤害"的制动策略(比如选择撞向哪个方向的伤害最小)。
特斯拉的FSD系统就大量使用了MPC技术。在复杂的城市场景中,FSD需要在每50毫秒内完成一次MPC优化——预测未来数秒的轨迹,选择最优控制,然后执行。这种"高频预测+优化"的能力,是FSD能够在复杂交通中流畅行驶的关键。
MPC与PID的关系:
MPC不是PID的"替代者",而是"升级者"。在实际的自动驾驶系统中,通常采用分层控制架构:
上层:MPC负责"轨迹规划"——决定车辆应该走哪条路径、以什么速度行驶。
下层:PID负责"轨迹跟踪"——控制方向盘、油门、刹车,让车辆精确地沿着MPC规划的轨迹行驶。
这种"MPC规划 + PID跟踪"的分层架构,结合了两种控制方法的优势:MPC的"预见性"和PID的"精确性"。
控制与感知的"深度耦合":从分层到端到端
传统的自动驾驶系统采用"分层"架构——感知层→决策层→控制层,各层之间通过明确的接口传递信息。这种架构的优势是"模块化"——每一层可以独立开发和测试。但它也有一个根本的局限:信息在层间传递时会"损失"。
举个例子:感知层输出"前方30米处有一辆车,速度20m/s"。这个输出是对原始传感器数据的"抽象"——它丢弃了很多细节信息(如车辆的姿态、轮胎的转向角、刹车灯是否亮起)。决策层基于这个"抽象"做出判断,然后传递给控制层。每一层都在"简化"信息,可能导致最终的控制决策不是"最优"的。
端到端控制(End-to-End Control)试图打破这种分层,让传感器数据直接映射到控制输出,中间没有明确的"感知""决策""控制"分界。特斯拉的FSD V12就是端到端架构的典型代表——它用一个神经网络直接从8个摄像头的视频流输出转向、加速、刹车信号。
端到端控制的优势是:信息不会在中途"损失",系统可以学习到人类难以显式建模的"微妙模式"。 比如,人类驾驶员在跟车时会不自觉地"预判"前车的意图——前车刹车灯微亮、车身轻微下沉,人类就知道"它可能要刹车了",于是提前松油门。这种"微妙模式"很难用传统的"分层"架构来建模,但端到端神经网络可以从数据中"学习"到。
但端到端控制也有风险:它是一个"黑箱"(Black-box System)——难以解释其决策原因,也无法预判其在何种情况下会出现性能骤降。 这对于安全关键系统(如自动驾驶)是一个严峻的挑战。
目前,业界倾向于一种"混合架构"——端到端网络负责"主要控制",传统的安全层负责"兜底"(在检测到危险时接管或干预)。这种"端到端+安全层"的架构,试图兼顾"性能"和"安全"。
4.5 本章小结:行动是智能的"出口"
本章探讨了具身智能的"四肢"——行动。从PID控制的反馈逻辑到运动规划的路径选择,从物理极限的约束到柔顺控制的交互,从PCA闭环的完整拼图到PCAP闭环的进化方向。
PID控制是反馈逻辑的基石。比例项"看当前",积分项"看历史",微分项"看趋势"——三者合一,用最简单的数学形式解决了最复杂的控制问题。从空调到火箭,PID控制无处不在。
运动规划让机器不仅"知道去哪里",还"知道怎么去"。A*算法寻找最优路径,RRT算法探索复杂空间,人工势场法模拟引力斥力——不同的算法适用于不同的场景。
物理极限是行动的"镣铐"——惯性、摩擦、电机极限、能量限制。好的具身智能系统不是试图打破这些镣铐,而是学会戴着镣铐跳舞,在约束中找到最优解。
PCA闭环的完整运转,才是具身智能的"活"的形态。感知提供输入,认知驱动决策,行动输出行为——三者循环往复、相互塑造、不断进化。
延迟是闭环的隐形杀手。从感知到认知到行动,每一个环节的时间累积起来,可能在高速场景中造成致命的后果。降低延迟是自动驾驶工程的核心挑战之一。
PCAP闭环代表了未来的方向——从"反应式"到"前瞻式",从"看懂当前"到"看透未来"。
到此为止,已完成对PCA闭环三个环节的系统探讨。第二篇"解剖机器人的身与脑"也接近了尾声。在接下来的第三篇中,将探讨一个更具前瞻性的领域——平行宇宙。下面将探讨机器如何在虚拟世界中学习和成长。
专栏4-1 PID控制的百年传奇:从1922年发明到SpaceX火箭
PID控制的历史可以追溯到1922年,当时俄裔美国工程师尼古拉斯·米诺尔斯基(Nicolas Minorsky)在研究军舰的自动舵系统时,首次提出了PID控制器的概念。他发现,通过同时考虑误差的比例、积分和微分三个维度,可以实现比单一比例控制更稳定、更精确的舵机控制。
在随后的100年里,PID控制经历了从模拟电路到数字芯片、从单回路到多回路、从人工调参到自动调参的 evolution。但它的核心原理——"测量误差,按比例/积分/微分调整输出"——从未改变。
SpaceX的猎鹰9号火箭在着陆时,使用的就是PID控制(以及更高级的变种)。火箭从太空返回,需要在指定位置精确着陆。这个过程涉及高度控制、速度控制、姿态控制等多个PID控制回路。火箭底部的栅格翼和发动机推力矢量控制系统,就是PID控制的"执行器"。当火箭接近着陆平台时,PID控制器会精确调整发动机的推力,让火箭以几乎为零的速度、垂直的姿态、精确的位置着陆——这个过程的精度要求极高,稍有偏差就会坠毁。
SpaceX的工程师们通过不断优化PID参数和改进控制算法,实现了火箭的重复使用——这是航天史上的里程碑式成就。而在这个成就的背后,是100年前米诺尔斯基发明的那个简单公式。
专栏4-2 Atlas演示中的姿态失稳:技术挑战的客观分析
2026年1月的CES展会上,波士顿动力Atlas在演示后空翻时落地不稳,手部保护罩甩飞。这一姿态失稳事件被现场观众记录并在社交媒体传播,引发了广泛讨论。
但从技术角度分析,这一事件比任何一次成功的演示都更具研究价值。
首先,它揭示了物理世界的复杂性永远无法被完全建模。 再先进的算法、再强大的算力,也无法保证机器人在每一次与真实世界的交互中都完美无缺。Atlas的后空翻在训练场上可能成功了一千次,但第1001次可能因为地面温度、空气流动、电池状态的微小变化而失败。
其次,它展示了具身智能的"学习闭环"在真实运转。Atlas出现姿态失稳后,波士顿动力的工程师团队进行了系统性分析——识别根因、调整控制参数、重新优化训练流程——在后续的演示中,Atlas完成了连续空翻。从"姿态失稳"到"成功演示"的快速迭代,正是PCA闭环在工程实践中的体现。
最后,它为具身智能系统的评价提供了重要启示:在评价具身智能系统时,不应该只看"成功率",还要看"失败后的恢复能力"。 一个"永远不出错"的系统(如果存在的话)可能只是在高度受控的环境中运行;一个"偶现偏差但能快速恢复"的系统,才是真正适应复杂世界的智能体。
专栏4-3 从仿真到现实的性能落差:Sim-to-Real挑战
在仿真环境中表现优异的控制策略,在真实世界部署时常出现显著的性能下降,这一现象的本质是Sim-to-Real鸿沟。
仿真环境是真实世界的简化模型。仿真中的路面是理想平面(真实世界中路面有起伏、有坑洼),仿真中的轮胎摩擦系数是常数(真实世界中摩擦系数随温度、湿度、磨损而变化),仿真中的传感器噪声通常是理想化建模(真实世界中传感器存在各种噪声和系统性误差),仿真中的其他车辆行为通常基于理性决策模型(真实世界中其他驾驶员的行为具有非理性特征)。
这些简化让仿真环境具有"干净""可控""可重复"的特性——这对算法开发非常有利。但这也意味着,在仿真中训练的策略,可能"过度适应"了仿真环境的特性,而在真实世界中表现不佳。
解决这个问题的方法包括:域随机化(在仿真中故意加入各种随机扰动)、域适应(学习仿真到真实的映射)、渐进式迁移(从仿真到半仿真到真实,逐步过渡)。第6章将详细讨论这些方法。
延伸阅读:从MPC到强化学习:现代控制理论的进化
PID控制虽然经典,但它也有局限:它只能处理"线性系统"(输入和输出之间成正比关系),而且需要人工调整参数。对于复杂的非线性系统(如人形机器人的运动控制),PID控制往往不够用。
模型预测控制(Model Predictive Control, MPC)是现代控制理论的重要发展方向。MPC的核心思想是:在每一时刻,根据系统的当前状态和一个"预测模型",预测未来一段时间内系统的行为,然后在这个预测范围内求解一个"最优控制问题",找到使某种"性能指标"最优的控制序列。最后,只执行这个序列的第一个控制动作,然后在下一时刻重新进行预测和优化。
MPC的优点是:能够处理多输入多输出系统、能够处理约束条件(如速度限制、力矩限制)、能够进行"前瞻式"控制。它的缺点是:计算量大,需要实时求解优化问题。
强化学习控制是另一个重要方向。如3.1节所讨论的,强化学习通过"试错+奖励"来学习最优控制策略,不需要人工建立精确的数学模型。这使得它特别适用于那些"难以建模"的系统——比如人形机器人在复杂地形上的行走。
近年来,MPC和强化学习正在"融合":用强化学习来学习MPC的"预测模型",或者用MPC来"约束"强化学习的探索空间。这种"强强联合"的方法,正在成为复杂机器人控制的主流方向。
【实验四】用PID实现虚拟小车自主循迹——行动是智能的"出口"
聚焦问题:不依赖手动操控,如何使虚拟小车自主沿赛道行驶?
实验目标
理解PID控制算法的基本原理(比例P、积分I、微分D)
通过调整PID参数,使虚拟小车自动通过第一关赛道
分析PID算法在不同关卡上的失效原因,理解反馈控制的局限性
体验"带着镣铐跳舞"——在物理约束下优化控制策略
实验内容与步骤
步骤1:已有PID算法尝试第一关(10分钟)
运行PIDdrive.py代码,观察小车的自动驾驶表现。可以看到小车在赛道上行驶——有时会沿着赛道中心线平稳前进,有时则会左右摇摆甚至冲出赛道。
调整Kp(比例增益)、Ki(积分增益)、Kd(微分增益)三个参数,使小车稳定通过第一关。调参策略参考本章4.1.3节:
先调Kp:增大Kp让小车对"偏离赛道"更敏感,但太大会导致震荡
再加Ki:加入Ki消除"稳态误差"(小车一直偏向一侧的问题)
最后调Kd:加入Kd抑制"超调"(小车冲过头的问题)
思考问答:
PID算法中的"偏差"是如何计算的?(提示:当前位置与赛道中心的距离)
调整Kp、Ki、Kd时,小车的行为分别有什么变化?Kp过大或过小分别会导致什么现象?
本章知识链接:
4.1.2节"PID控制:工业文明的隐藏基石"——P/I/D三个项的物理意义
4.1.4节"从空调到机器人"——PID从空调温控到小车控制的通用性
步骤2:已有PID算法尝试第二关,分析失效原因(10分钟)
用第一关调好的PID参数运行第二关。通常会发现:小车在第二关表现不佳——要么冲出赛道,要么在弯道处转向过度。
分析原因:第二关的弯道更急,PID算法计算出的"偏差"(当前位置与赛道中心的距离)在急弯处变化更快,而PID的"反应"跟不上这种快速变化。
思考问答:
为什么在第一关表现良好的PID参数,在第二关会出现性能下降?
如果要让PID通过第二关,需要改进什么?(提示:更精确的偏差检测)
本章知识链接:
4.3节"带着镣铐跳舞"——PID控制受限于"偏差检测"的精度
4.3.2节"鬼探头场景中的物理约束"——PID只能"跟随"规则,不能"理解"场景
步骤3(融会贯通):修改PID算法通过第二关(60分钟)
这是实验的核心挑战环节。实验要求如下:
理解PIDdrive.py代码中"偏差"的计算方式
通过计算机视觉技术获得更准确的偏差量(如检测赛道中心线位置)
修改代码,使小车能够通过第二关
评分标准:算法达到预期效果(通过第二关)并能说明工作原理。
本章知识链接:
4.2节"运动规划"——PID是一种"路径跟踪"控制策略
4.4节"PCA闭环"——PID是"感知(摄像头)→认知(偏差计算)→行动(转向控制)"的闭环
实验报告
记录实验最终确定的Kp、Ki、Kd参数值。描述调参过程中观察到的现象。
PID控制属于"规则驱动"还是"数据驱动"?它的优势和局限分别是什么?
如果赛道上有障碍物(第五关),PID控制还能工作吗?为什么?
对比【实验二】(手动控制)和本实验(PID控制)——人类驾驶与机器驾驶在"决策逻辑"上的差异是什么?
第三篇 平行宇宙与现实跨越(我往何处去)
本章互动
2 条读者反馈- 匿名读者提问已采纳
PID 的微分项会放大噪声,工程上一般怎么滤?讲义能否加一段说明?
教师回复:好问题,v1.1 将在 4.1 节增加“微分项先行滤波”的工程处理段落。