第 1 章 · v1.1 · 全文呈现
从科幻到现实:什么是具身智能
看本章讲解视频第一篇 概念与觉醒(我是谁)
第1章 从科幻到现实:什么是具身智能
1.1 引子:两个具有全球影响力的瞬间
1.1.1 AlphaGo的"局限":棋盘上无敌,棋盘外无知
2016年3月9日,韩国首尔四季酒店。世界围棋冠军李世石九段坐在一张深色木质棋盘前,对面没有人,只有一个屏幕和一台远在伦敦的电脑。这一天,被《科学》杂志称为"人工智能的登月时刻"——人类顶尖棋手与人工智能的首次公开对决正式拉开序幕。
赛前,几乎所有人都认为李世石会轻松取胜。毕竟,围棋曾被称作"人类智慧的堡垒"。它的棋盘上有361个交叉点,每一步棋的合法走法平均约有250种,一盘棋可能的走法数量超过了宇宙中的原子总数。2012年,国际象棋大师卡斯帕罗夫就预言:"计算机要在围棋上战胜人类冠军,至少还需要二十年。"然而就在四年后,AlphaGo来了。
五局棋下来,比分是4:1,AlphaGo大获全胜。但这1:3中的那个"1",却成为了整个人机大战中最耐人寻味的一页。
那是第四局的第78手。前三局已经0:3落后的李世石,面对的是一个几乎不可能翻盘的局面。AlphaGo的黑棋在棋盘上方围出了一片令人窒息的空地,白棋似乎被逼入了绝境。在观战室里,中国围棋冠军古力摇了摇头——即使是换成他和AlphaGo对调位置,他也觉得无力回天。
就在所有人的屏息注视中,李世石长考了二十多分钟,然后下出了一步谁都没有想到的棋——在棋盘中腹的一"挖"。这手棋违背了太多常识,在职业棋手眼中并不成立。古力在直播间里惊呼:"这是'神之一手'!前四盘棋中最漂亮的一手!"
奇妙的事情发生了。在这手棋之后,AlphaGo接下来的五手棋陷入了明显的混乱,接连走出了毫无意义的"昏招"。局势瞬间倒向了白棋一方。坐在屏幕前替AlphaGo落子的黄士杰博士,第一次露出了困惑的表情——他需要把棋谱传回伦敦的DeepMind总部,等待超级计算机集群的决策。
AlphaGo的开发者哈萨比斯后来承认:"AlphaGo在第79手犯了错,但直到第87手左右,它才意识到自己错了。"〔69〕〔72〕 最终,行至第180手,AlphaGo投子认负。这是人类对AlphaGo获得的唯一一场公开胜利。
李世石在赛后说,第78手是自己"看到唯一可以落子的地方"。但这恰恰暴露了一个深层问题:这手棋在围棋的棋理上是"不成立"的——如果AlphaGo应对正确,白棋依然无法出棋。可AlphaGo"漏算"了这一系列组合拳。为什么?因为深度学习学到的是统计知识,而非精确的逻辑知识。在复杂对杀和复杂劫争中,它存有盲点。李世石那看似"不成立"的一手棋,恰好落在了AlphaGo算法的盲区里。
但这并不是AlphaGo的"失误"那么简单。若从另一视角分析:AlphaGo能下出超越人类千年的棋,为什么会在一步看似简单的棋上出现判断偏差?
答案藏在AlphaGo的"身体"里——或者说,它根本没有身体。
AlphaGo是一个纯粹的"大脑"。它不吃不喝、不眠不休,用1920个CPU和280个GPU同时运算,能在几秒内评估数百万种棋局变化。但它从未真正"触摸"过一颗棋子,从未感受过棋子落在棋盘上的"咔哒"声,从未体验过对局室里紧张到凝固的空气,更不知道赢了一盘棋之后的香槟是什么味道。它的智能被永远锁死在围棋棋盘上——离开棋盘,AlphaGo不具备任何实际应用能力。它不能把围棋智慧迁移到任何其他任务,不能理解棋局之外的世界,更不能将棋盘上练就的"直觉"应用到生活中。
这就是AlphaGo的"局限":其拥有人类无法企及的"超级大脑",却永远无法成为真正意义上的"智能体"。李世石在2019年退役时留下一句话:"围棋需要被人理解,而我,始终在寻找那种理解的极限。"〔66〕 十年后回望,这句话有了新解——AlphaGo理解了围棋的统计规律,却从未真正"理解"围棋,因为它没有身体去承载那种理解。
以下对该问题作进一步分析。AlphaGo的"大脑"本质上是一个超级复杂的模式匹配系统。它看过三千万盘棋谱,记住了每一种局面下胜率最高的走法。当你跟它下棋时,它并不是在"思考"这盘棋的战略意图,而是在它的"记忆库"里查找最相似的棋局,然后选择那个胜率最高的走法。这就是深度学习的本质:它不是"理解",而是"联想"。
这种"联想式智能"在围棋这个封闭、规则明确、数据丰富的领域里如鱼得水。但在现实世界中,绝大多数问题都不是围棋。现实世界是开放的、混乱的、充满意外的。你不可能为"如何在拥挤的地铁里找到座位"准备三千万个训练样本,也不可能为"如何在暴雨中安全驾驶"穷尽所有可能的场景。AlphaGo的智能是"温室里的花朵"——在精心设计的棋盘上绽放,一旦移植到现实的土壤中,就会枯萎。
更深层的问题在于:即使你把AlphaGo的算法原封不动地搬到另一个领域——比如国际象棋——它也完全无能为力。不是因为它"不够聪明",而是因为它的"聪明"是专门为围棋设计的。它的神经网络结构、它的输入数据格式、它的输出动作空间,都是为361个交叉点、黑白两色棋子、特定的围棋规则量身定制的。给它一副国际象棋棋盘,它连"这是一个棋盘"都认不出来,因为它的"眼睛"只认识围棋棋盘的像素模式。
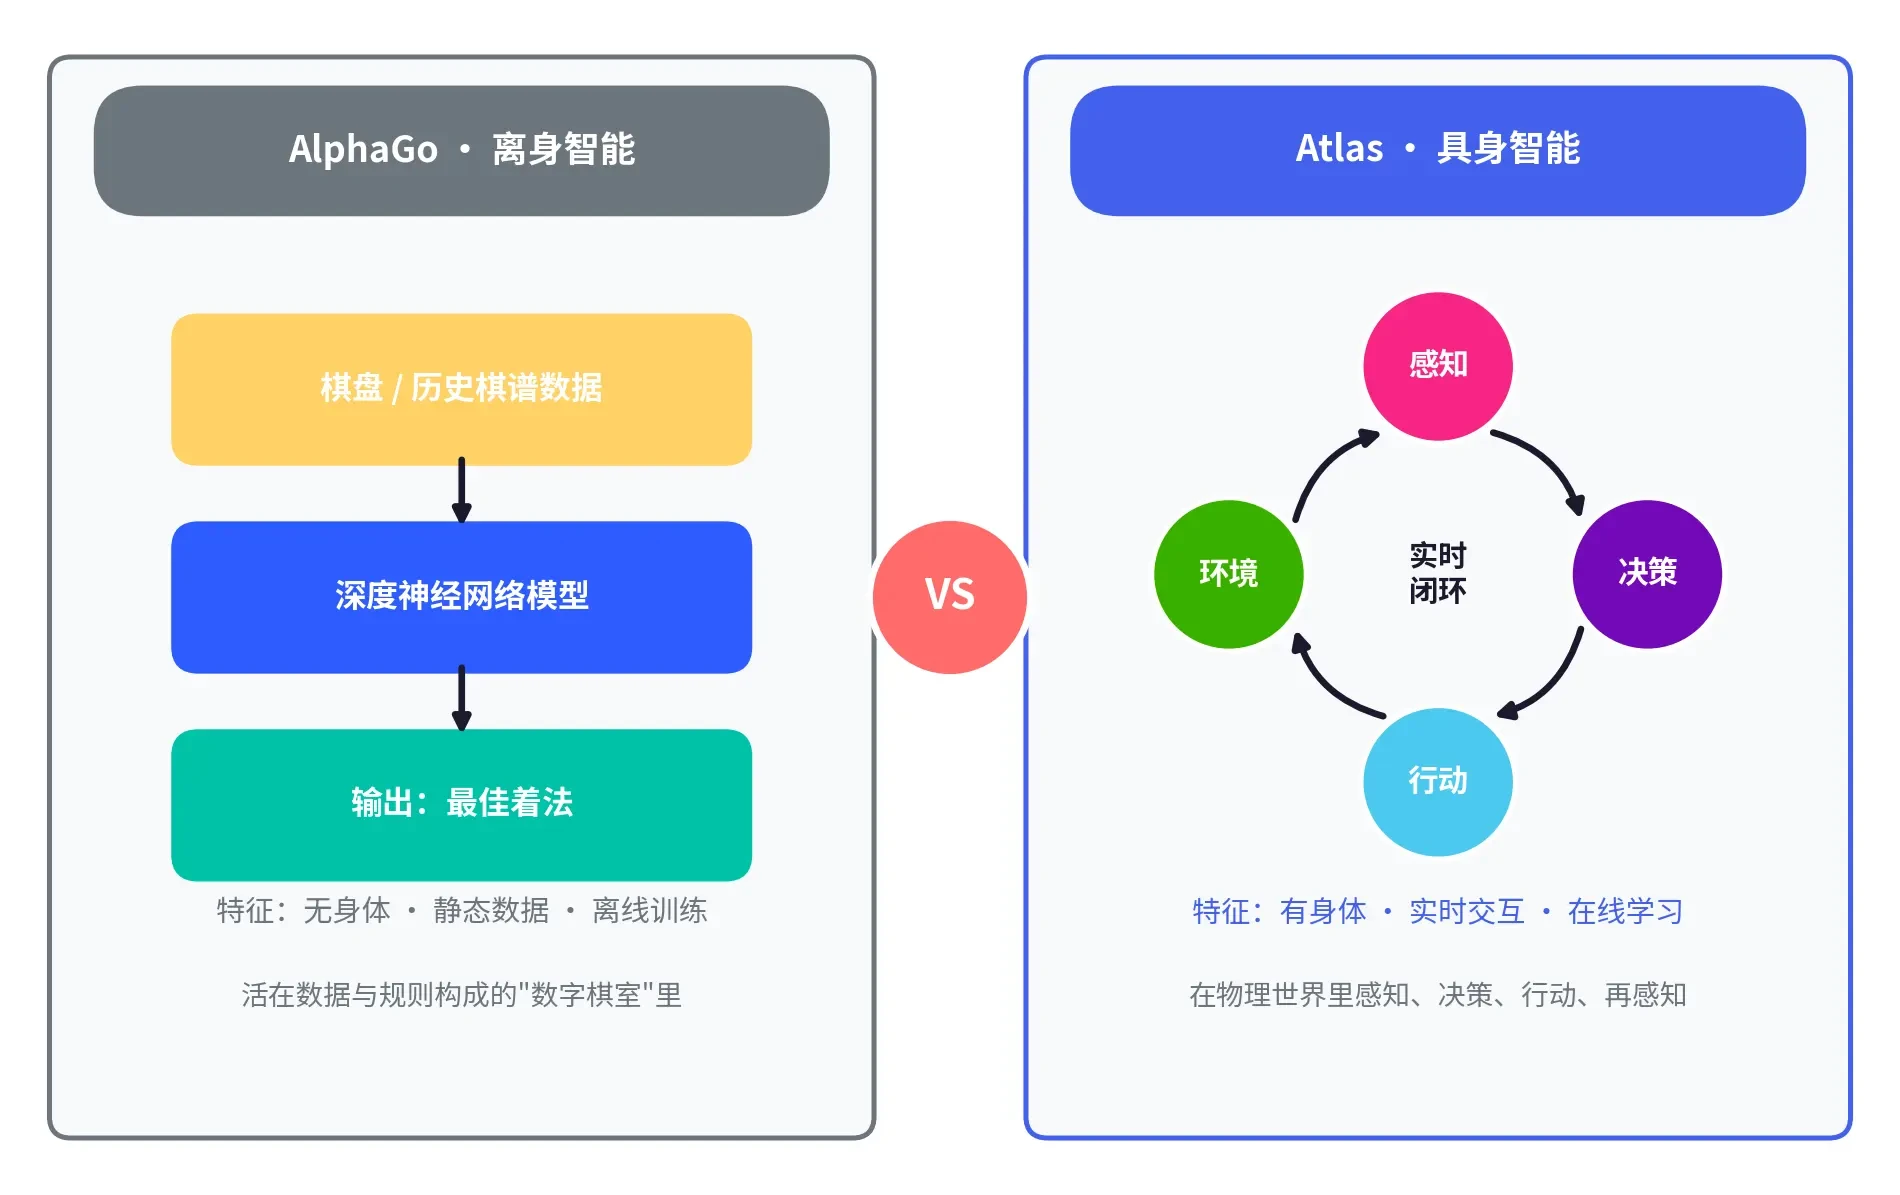
这就是离身智能(Disembodied Intelligence)的根本局限:没有身体,就没有感知;没有感知,就没有与世界的交互;没有交互,智能就被永远锁死在特定的符号空间里。AlphaGo可以记住宇宙中所有的围棋棋局,但它永远不知道"拿起一颗棋子"是什么感觉。它可以计算出最优的胜率,但它永远不会因为一盘棋的胜负而心跳加速。它的"智能"是纯粹的、冰冷的、与身体割裂的——这就是为什么我们叫它"离身智能"。
1.1.2 波士顿动力Atlas的后空翻:身体知道答案
另一具有重大技术意义的瞬间是。
2017年11月,波士顿动力公司发布了一段视频:一个身高约1.5米的人形机器人在一个软垫前站定,双臂摆动,双腿弯曲,然后腾空而起,在空中完成一个360度后空翻,稳稳落地。它的名字叫Atlas。
那一刻,全世界为之震惊。YouTube上的视频播放量迅速突破千万。社交媒体上,人们在惊叹:"这是什么黑科技?""机器人要统治世界了吗?"连一向冷静的《麻省理工科技评论》也发文感叹:"这是机器人运动能力的一次飞跃。"
但真正的震撼,发生在近十年之后。
2026年2月,波士顿动力发布了最新视频:新一代全电动Atlas完成了一组连续动作——侧手翻接后空翻,动作衔接流畅,落地稳健。这不是简单的"更灵活了",而是具身智能在物理世界中"落地生根"的缩影。〔54〕〔55〕
以下分析Atlas的物理构造:它拥有56个自由度(Degrees of Freedom, DOF)关节,每一个关节均可独立运动,相当于人类身体关节数的两倍以上。其配备了360度全向摄像头,无需转头即可观察身后环境。其运动算法融合了强化学习(Reinforcement Learning, RL)能力,可通过观察人类动作自主学习新技能。最关键的是,它采用了全电动驱动系统——不需要液压管、不需要外接电源,单靠自身的电池就能运行4个小时。〔67〕〔68〕
但Atlas的故事里,最具教学价值的并非成功本身,而是"试验中的失稳"。
2026年1月的CES展会上,Atlas在演示后空翻时落地不稳,手部保护罩甩飞了出去。这个片段被观众拍下来发到了网上,一时间成了科技圈的热议话题。但深入分析这一事件——"失稳"本身比"成功"更具教育意义。它提醒我们:物理世界的复杂性永远无法被完全建模。再先进的算法、再强大的算力,也无法保证机器人在每一次与真实世界的交互中都完美无缺。〔57〕〔58〕
那个甩飞的手部保护罩,恰恰是具身智能最真实的注脚。
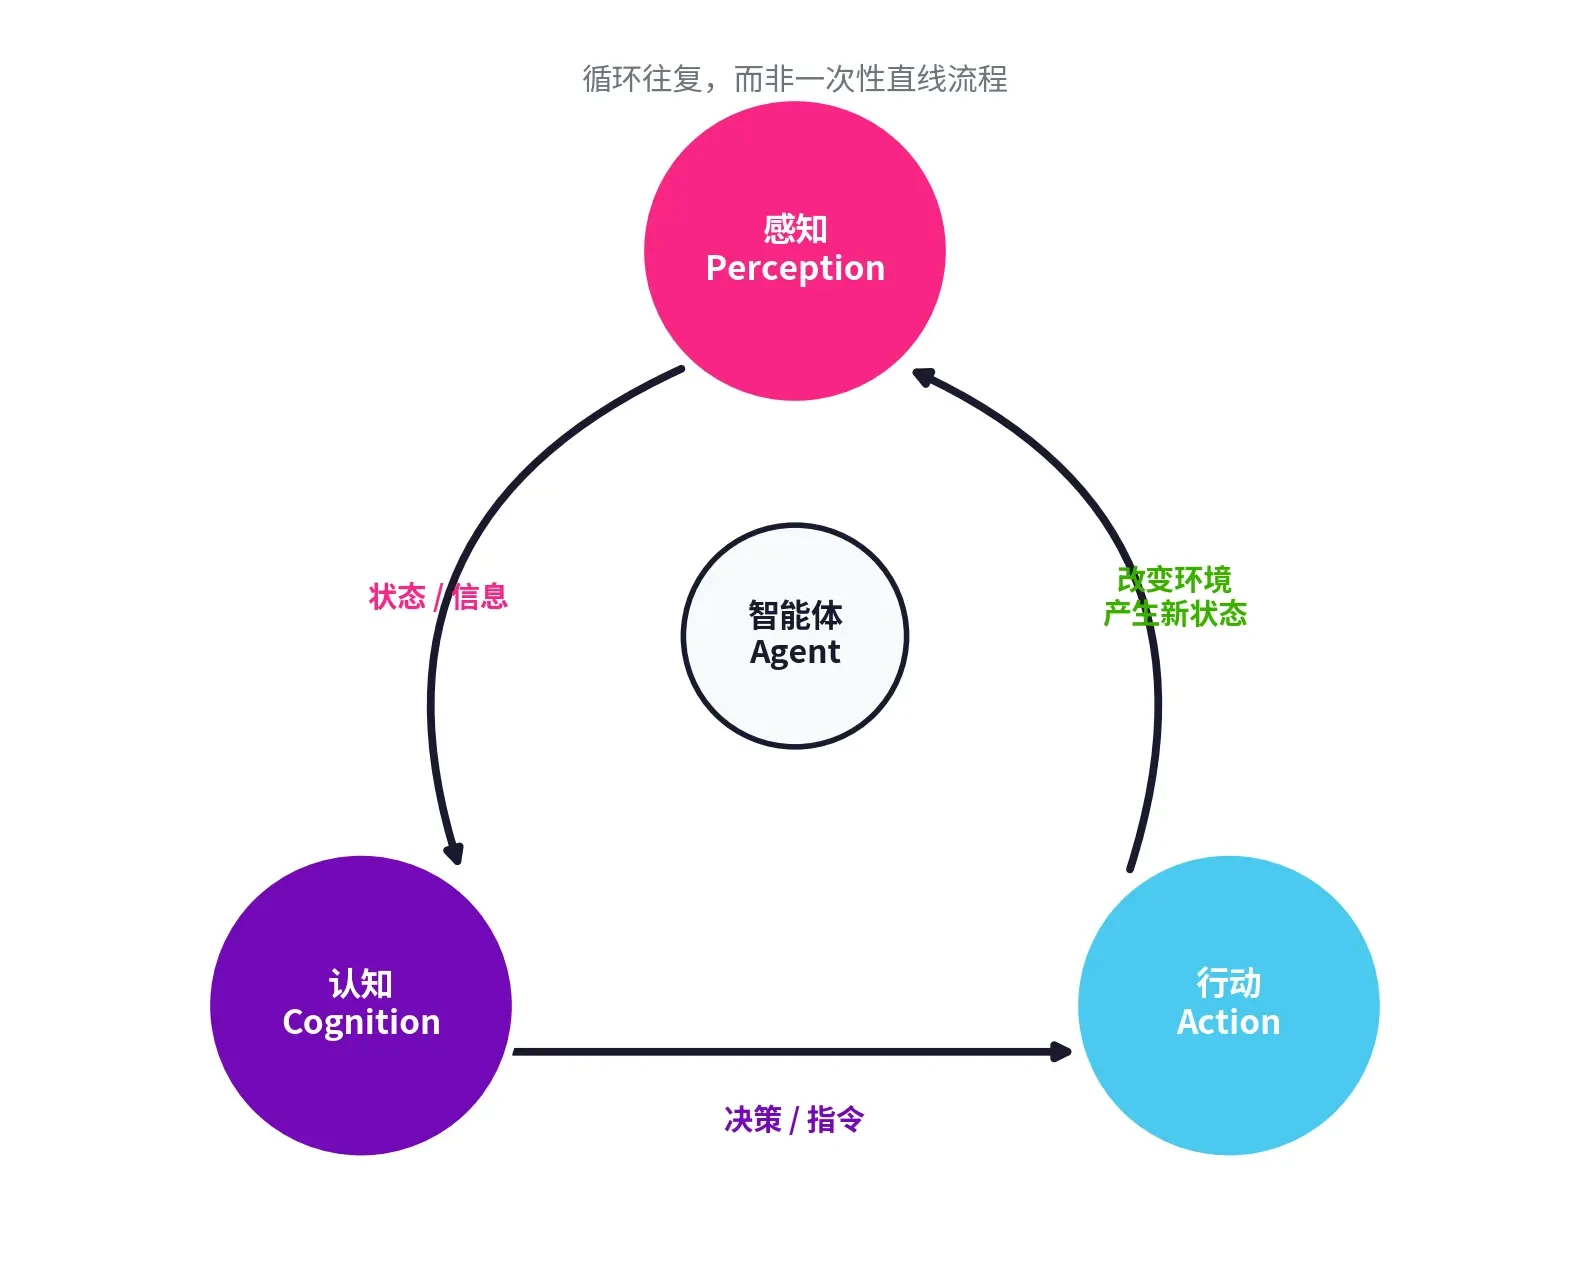
而就在"失稳"的一个月后,Atlas就完成了连续空翻。从踉跄到稳健,只用了一个月。这不是魔法,而是具身智能的学习闭环在运转:感知(摄像头看到落地姿态)→认知(算法判断哪里出了问题)→行动(调整电机参数)→新的感知(下一次空翻更稳)→新的认知→新的行动……循环往复,直到"失稳"变为"成功"。
需要特别关注一个关键的区别。AlphaGo的"学习"发生在服务器机房里,通过分析数百万盘棋谱来完成。它的每一次"进步"都是离线的、抽象的、与物理世界无关的。但Atlas的"学习"发生在真实的物理空间中——它的每一次跳跃、每一次落地、每一次"失稳",都是它与重力、摩擦力、惯性、空气阻力这些物理法则的直接对话。Atlas不是在"计算"后空翻,而是在"体验"后空翻。它的身体记住了"在空中收起手臂能让旋转更快",它的关节记住了"落地时膝盖弯曲15度最能吸收冲击力"——这些"知识"不是写在代码里的,而是从身体与物理世界的无数次交互中"生长"出来的。
这就是为什么Atlas代表了一种完全不同的智能范式。AlphaGo告诉我们:给机器足够的数据和算力,它可以成为某个狭窄领域的超人。Atlas告诉我们:给机器一个身体,让它在真实世界中摸爬滚打,它可以获得一种完全不同的智能——一种扎根于物理世界、能够从经验中成长、能够适应未知环境的智能。这就是具身智能(Embodied Intelligence)的承诺。
2026年2月的最新消息:现代汽车集团已经向波士顿动力下了3万台Atlas的订单,计划2028年投入汽车工厂执行零件分拣任务。〔54〕〔59〕 那个曾经只会翻跟头的"特技演员",即将穿上工装,走进生产线。这意味着什么?意味着具身智能不再只是实验室里的"表演艺术",它正在变成改变世界的生产力。
1.1.3 两个故事的交汇:什么是智能的"完整形态"?
AlphaGo和Atlas,这两个看似截然不同的智能体实例,其实指向了同一个根本问题:什么是智能的"完整形态"?
AlphaGo拥有超级"大脑",可以在围棋上碾压人类冠军,但它没有身体,无法与世界发生任何物理交互。它的智能是"离身"的——离开了围棋棋盘,它不具备任何通用能力。
Atlas拥有灵活的身体,可以在物理世界中奔跑、跳跃、翻转,但它的大脑还远远比不上AlphaGo。它不能下围棋、不能写诗、不能进行哲学思辨。它的智能是"具身"的——必须通过身体与世界的交互才能展现。
如果有一个"完整体"——既有AlphaGo那样的超级大脑,又有Atlas那样的灵活身体,能下棋也能翻跟头,能思考也能行动——那会是智能的终极形态吗?
也许。但在本书中,我们将带领读者探索一条不同的路径。不急于回答"终极形态是什么",而是先问一个更根本的问题:
智能,是否必须依赖身体?
这个问题不是技术问题,而是哲学问题。它困扰了人类两千多年——从古希腊的柏拉图(Plato)到17世纪的笛卡尔(René Descartes),从20世纪的梅洛-庞蒂(Maurice Merleau-Ponty)到21世纪的认知科学家。柏拉图认为,真正的知识是灵魂对"理念世界"的回忆,身体是囚禁灵魂的"牢笼";笛卡尔提出了著名的"我思故我在"(Cogito, ergo sum),把"思维"(心智)与"广延"(身体)彻底分离。这些思想在西方哲学中统治了两千多年,也在很大程度上塑造了传统人工智能的研究范式——"智能=大脑的符号运算,身体只是载体"。
但具身认知(Embodied Cognition)的兴起,正在动摇这个根深蒂固的观念。越来越多的证据表明:没有身体,就没有心智;没有与世界的交互,就没有真正的理解。AlphaGo也许是"离身智能"的巅峰之作——它在围棋这个封闭的符号空间里达到了超人的水平。但正是这种"离身",注定了它的局限。而Atlas虽然还远未达到人类的认知水平,但它的每一次跳跃、每一次失稳后的重新站起,都在演绎着一个不同的智能范式——智能不是被"编程"出来的,而是从身体与世界的交互中"生长"出来的。
为了回答"智能是否必须依赖身体"这个问题,我们需要回到认知科学(Cognitive Science)的源头,看看"身体"和"心智"到底是什么关系。
1.2 离身与具身:身体如何决定心智?
1.2.1 离身智能:"缸中之脑"的幻想
现提出一个思想实验。
假设你的大脑被一位科学家取了出来,放在一个装满营养液的缸子里。科学家用精密的电极连接你的大脑神经,向你输送所有感官信号——你看到的一切、听到的一切、感觉到的一切,都是计算机模拟出来的。你"看到"的阳光其实是电信号,你"触摸"到爱人的手其实也是电信号。你对此一无所知,你以为自己正坐在家里读这本书。
这就是哲学史上著名的"缸中之脑"(Brain in a Vat)思想实验,由美国哲学家希拉里·普特南(Hilary Putnam)在1981年提出。它的核心问题是:如果你的所有感官体验都是虚假的,你怎么知道自己不是"缸中之脑"?
传统的人工智能研究,某种程度上就是在构建"缸中之脑"。研究者们假设:智能的本质是大脑的符号运算,身体只是一个无关紧要的"硬件载体"。就像一台电脑——CPU才是重要的,机箱是什么形状、什么颜色,根本不影响计算能力。
在这种假设下,AlphaGo就是最完美的"离身智能"。它不需要身体,只需要足够大的算力和足够多的数据。给它足够的围棋棋谱,它就能成为围棋之神。给它足够多的医学影像,它就能成为诊断大师。给它足够多的法律文书,它就能成为最厉害的律师。
但问题来了:为什么AlphaGo在围棋上无敌,却无法回答"今天天气怎么样"?为什么它在棋盘上神机妙算,却在第78手时犯了一个业余级错误?
答案很简单:因为它没有身体。没有身体,就没有"世界"。没有世界,所有的智能都是空中楼阁。
以一个贴近日常经验的案例说明来说明。想象一下,你正在学习骑自行车。你读了无数本关于骑自行车的书——平衡原理、力学公式、重心计算。你甚至看了一万个骑自行车的教学视频。你觉得你已经"懂"了骑自行车。但当你第一次跨上自行车的时候,你还是会摇摇晃晃、摔倒在地。为什么?
因为骑自行车不是"知识",而是"技能"。它不是储存在你大脑里的符号,而是你整个身体——包括你的肌肉、你的平衡感、你的前庭系统——与自行车和环境共同构成的一个动态系统。你的身体"知道"怎么保持平衡,但你的大脑可能"解释"不清。
这就是离身智能的根本局限:它只能处理符号,无法获得技能。
还有一个更深层的问题:离身智能无法真正"理解"它处理的内容。AlphaGo可以下出完美的围棋,但它不知道"围棋"是什么。对它来说,围棋只是一串数字——棋盘上每个交叉点的状态(0表示空、1表示黑棋、-1表示白棋),以及一个目标函数(最大化胜率)。它不知道围棋是两个人面对面坐着进行的古老游戏,不知道棋手在对弈时的紧张与兴奋,不知道一盘好棋可以像一首诗一样优美。它的"理解"是扁平的、去语境化的、没有"意义"的。
相比之下,一个会骑自行车的人"理解"骑自行车是什么——不是通过阅读说明书,而是通过他的身体记住了平衡的感觉、风从耳边吹过的感觉、转弯时身体倾斜的感觉。这种"理解"是嵌入在身体中的,是充满"意义"的。这就是为什么一个自行车冠军可能完全不懂力学公式,但他骑得比任何懂公式但不会骑的人都好。
1.2.2 具身认知:第二代认知科学的革命
20世纪80年代,认知科学领域发生了一场静悄悄的革命。一群心理学家、哲学家和神经科学家开始质疑一个流传了几百年的假设:心智真的可以被简化为大脑的符号运算吗?
其中最具影响力的一位,是法国现象学家莫里斯·梅洛-庞蒂(Maurice Merleau-Ponty)。他在1945年出版的《知觉现象学》(Phénoménologie de la Perception)中提出了一个开创性的观点:身体不是心智居住的容器,而是我们"拥有"一个世界、生成所有意义的原初视角和动态界面。3946
这一表述较为抽象,以下以简明方式加以阐释。
想象一下你正在伸手去拿桌上的一杯水。在离身智能的框架下,这个过程可以被描述为一系列符号运算:大脑通过视觉获取杯子的位置信息(x, y, z坐标),计算出手的运动轨迹,发送指令给手臂肌肉,完成抓取动作。听起来很合理,对吧?
但梅洛-庞蒂会说:这个描述漏掉了最重要的东西。当你伸手去拿杯子的时候,你并不是在"计算"杯子的坐标。你和杯子之间有一种直接的、前反思的联系——你的手臂"知道"杯子在哪里,就像你的脚"知道"地面在哪里。这种"知道"不是通过符号运算实现的,而是通过你的身体与世界的长期交互"沉淀"出来的。
换句话说,不是你"有一个身体",而是你就是你的身体。 你的心智不是被困在头颅里的"小人",而是从整个身体与环境的交互中"生长"出来的。
这场哲学思辨在20世纪80年代得到了实验科学的强力支持。认知科学家们设计了一系列精巧的实验,证实了"身体影响认知"的惊人发现。
有一个经典的实验:研究者让被试在嘴里横着咬一支铅笔(这个姿势会让面部肌肉呈现"微笑"的状态),然后给他们看一些卡通图片,让他们评价这些图片有多好笑。结果发现,咬着铅笔的被试认为图片更好笑。为什么?因为"微笑"的身体姿态真的影响了"开心"的认知判断。49
还有一个实验:研究者让被试倾斜身体向前或向后,同时让他们判断一些词语是"积极的"还是"消极的"。结果发现,身体向前倾斜时,被试对积极词语的反应更快;身体向后倾斜时,对消极词语的反应更快。身体姿态影响了情绪判断。78
再举一个更生动的例子:热咖啡实验。2008年,心理学家威廉姆斯和巴奇做了一个巧妙的实验。他们让被试在实验室的大厅里等几分钟,期间请一位工作人员走过来,请被试帮忙拿一杯咖啡。这杯咖啡有的是热的,有的是冰的。拿完咖啡后,被试进入实验室,读到一段关于某个人的描述,然后评价这个人的"人格温暖度"。结果令人震惊:拿到热咖啡的被试认为这个人更"温暖"、更"友好";拿到冰咖啡的被试则认为这个人更"冷淡"。仅仅是手中咖啡的温度,就影响了他们对他人人格的判断!
这个实验揭示了一个深刻的事实:我们的身体状态——哪怕只是手心的温度——会无意识地渗透到我们的认知判断中。 这不是"分心"或"干扰",而是认知的"默认工作模式"。我们的大脑从来不是在"真空"中思考的,它始终浸泡在身体提供的感知信息流(sensorimotor stream)中。
还有一个关于"重量与重要性"的实验。研究者让被试分别拿着一个沉重的写字板和一个轻便的写字板,然后让他们对一份简历进行评价。拿到沉重写字板的被试认为这份简历更重要、更有价值。重量——这种纯粹的物理感受——竟然影响了人们对"重要性"这种抽象概念的判断!这就是为什么在英文里"weight"既有"重量"的意思,也有"重要性"的意思;在中文里,我们也会说"这件事很有分量"。这些语言中的隐喻不是偶然的,它们反映了身体经验如何塑造了我们的概念系统。
这些实验揭示了一个反直觉的事实:你的大脑不是认知的"司令部",你的身体也不是认知的"执行者"。认知是整个身体-环境系统的涌现属性。
基于这些发现,认知科学家们总结出具身认知的三大核心命题:3749
第一个命题:身体结构规定认知能力的范围。 蝙蝠用超声波感知世界,蛇用红外热感应捕食,鹰的视觉清晰度是人类的8倍。不同的身体结构,塑造了完全不同的"世界版本"。一只蝙蝠的"世界"里充满了回声的纹理,而这个世界对人类来说根本不存在。
第二个命题:身体结构决定认知产生的机理。 当你伸手去够一个物体时,"伸手"这个动作本身就在塑造你的空间认知。你不需要先在大脑里"计算"物体的位置,再发送指令给手臂。你的手臂和眼睛在交互中共同"生成"了空间感。这就是为什么盲人可以通过触摸来"看见"物体的形状——他们的身体找到了另一种方式来实现同样的认知功能。
第三个命题:身体、认知和环境组成动态统一体。 你不是"在你房间里",你和房间是一个不可分割的系统。你坐在椅子上,椅子支撑着你,你也同时"感知"着椅子。你走过一扇门,门的宽度、高度、把手的位置,都在塑造你对"空间"的理解。如果把你的房间缩小一半,你对"宽敞"和"狭窄"的判断就会改变。你的身体、你的认知和你的环境,是共同演化的。
这三大命题构成了第二代认知科学的核心框架,也为我们理解具身智能奠定了哲学基础。
1.2.3 从哲学到工程:具身智能的诞生
如果说具身认知是"人类心智的科学",那么具身智能就是"机器心智的工程"。
具身智能的基本思想很简单:如果我们想让机器拥有真正的智能,就不能只给它一个"大脑"(算法和算力),还必须给它一个"身体"(传感器和执行器),让它能够在真实世界中感知、行动、试错、学习。
中国工程院院士、西安交通大学人工智能与机器人研究所所长郑南宁教授,在2025年发表的一篇重要论文中给出了具身智能的权威定义:
"具身智能通过构建具有本体感知与行动能力的智能体,利用多模态传感器实时捕获环境状态,利用执行机构施加物理作用,并在连续时空维度中形成'感知-认知-决策-行动'的闭环学习系统。"77
这段表述较为学术化,以下对该定义作结构化解析:
具身智能 =一个有身体的智能体(机器人、自动驾驶汽车、无人机等)+一套传感器(摄像头、激光雷达、毫米波雷达等,相当于机器的眼睛、耳朵、皮肤)+一套执行机构(电机、液压系统、轮子、机械臂等,相当于机器的四肢)+一个算法大脑(目标检测、路径规划、强化学习等)+一个闭环学习机制(感知→认知→行动→反馈→再感知……循环往复)。
但这里有一个非常重要的澄清:具身智能的"具身",不是简单地"有身体"。
一张桌子有身体,但它不是具身智能。一块石头有身体,它也不是具身智能。关键不在于"有没有身体",而在于身体是否能够与环境形成动态交互的闭环。也就是说,机器必须能够:
感知环境的状态(看到、听到、触摸到)
理解这些状态的含义(不是"有像素",而是"有辆车冲过来了")
决定如何行动(刹车、转向、避让)
执行行动(踩下刹车踏板、转动方向盘)
感知行动的结果(车停住了吗?距离够吗?)
调整下一步行动(继续刹车还是松一点?)
这个循环不断运转,每一次运转都是智能的一次"生长"。这就是具身智能的核心——不是"有身体",而是"用身体与世界交互并从中学习"。
以下对AlphaGo与Atlas进行回顾比较。
AlphaGo没有传感器,没有执行器,没有与物理世界的任何交互。它只能在围棋棋盘上进行符号运算。所以它是离身智能——智能与身体完全分离。
Atlas有摄像头(感知),有电机和关节(执行),有与物理世界的持续交互(站立、行走、跳跃、摔倒、再站起来)。它在每一次交互中学习、调整、进化。所以它是具身智能——智能通过身体与世界的交互而涌现。
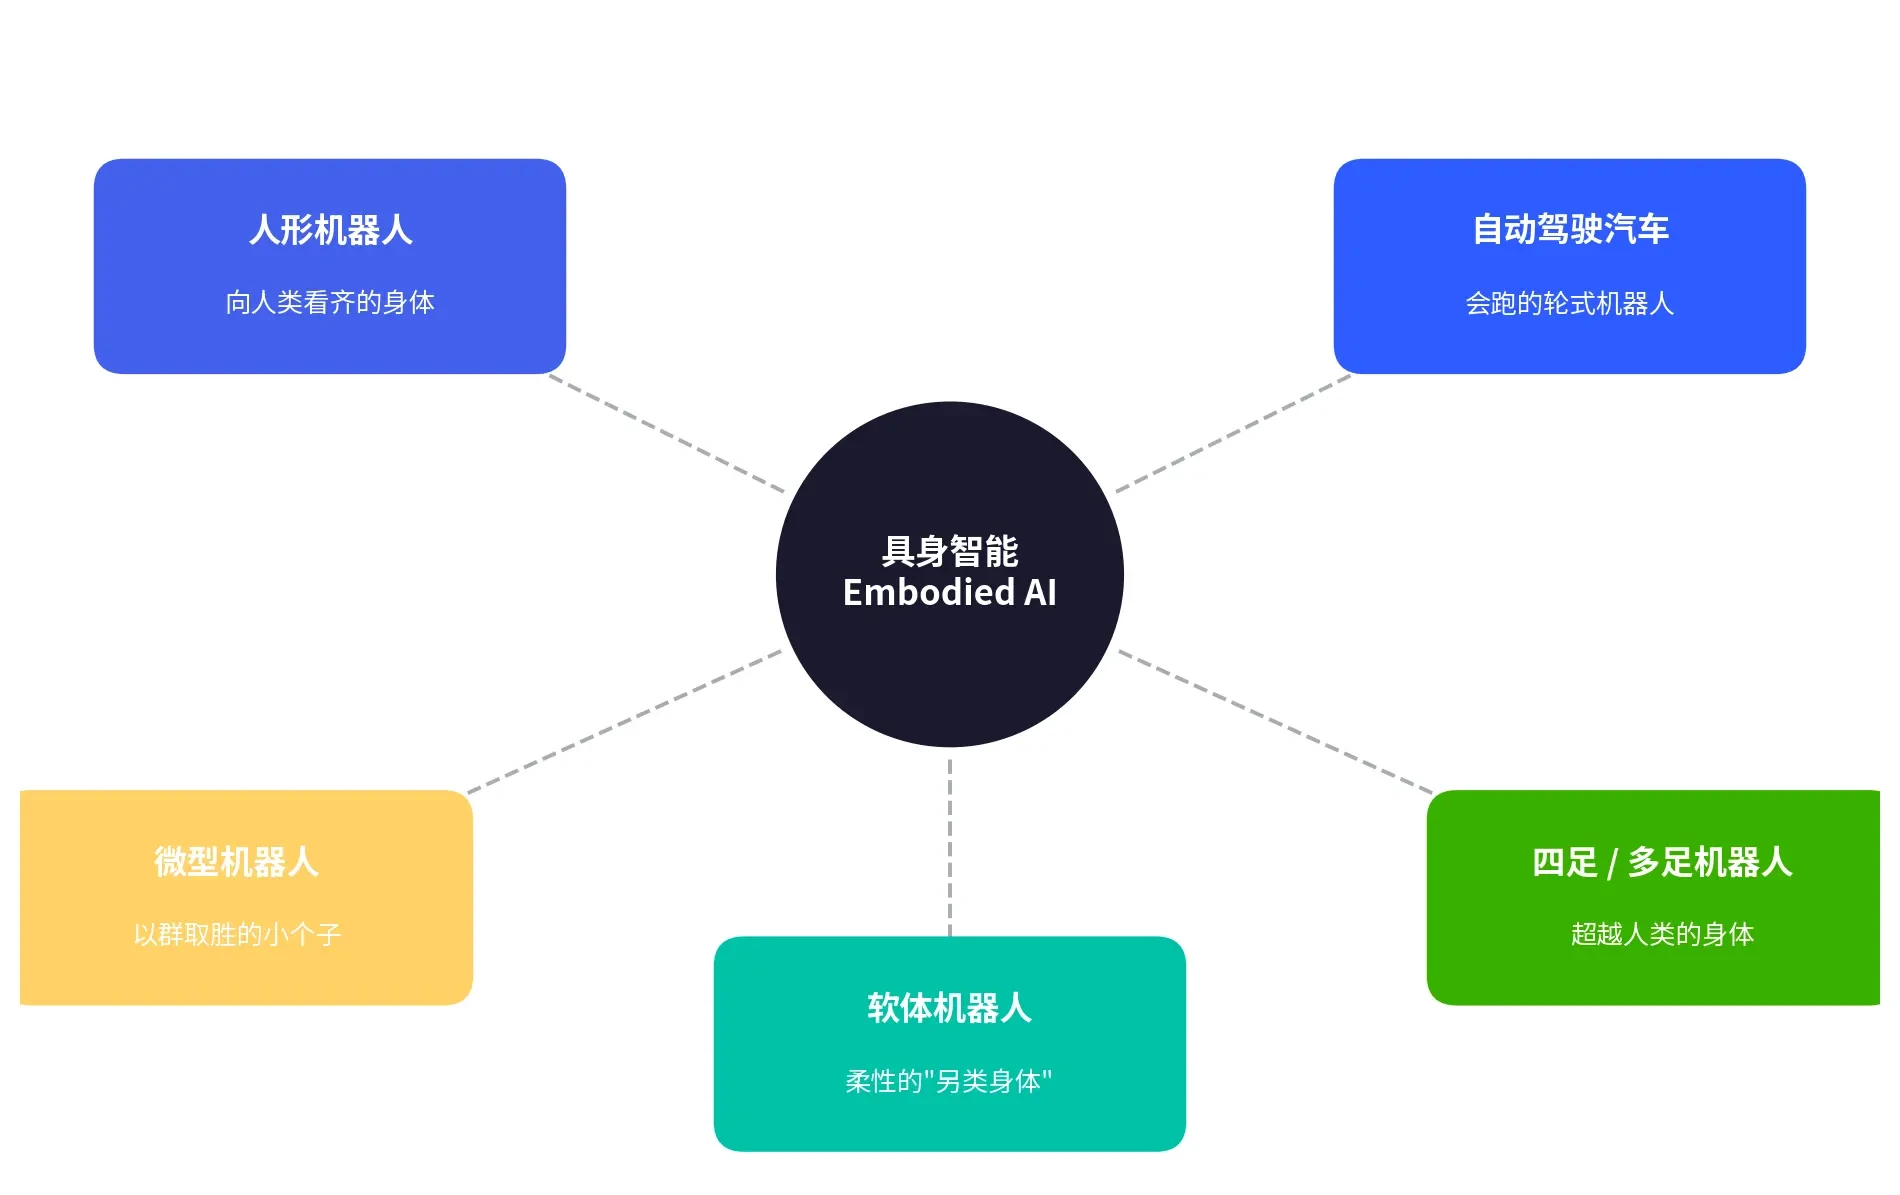
但这并不意味着Atlas比AlphaGo"更聪明"。Atlas不会下围棋,不会解数学题,不会写诗。它只是具身智能的一个"物种"——擅长身体运动的具身智能。具身智能的世界远比这丰富。以下介绍具身智能的"物种图谱"。
1.3 具身智能的系统观:感知、认知与行动的"三位一体"
1.3.1 感知(Perception):世界的"入口"
机器"看见"某物,其技术内涵是什么?
若询问非专业人士,他可能会说:"机器看见东西,不就是摄像头拍了一张照片吗?"这一表述部分成立。摄像头确实拍了一张照片,但"拍照片"不等于"看见"。
以一个生活中的案例说明。假设行人正走在一条熟悉的街道上,突然,前方人行道上的一个小东西吸引了其注意——那是一个被遗落的玩具球。在不到一秒钟的时间里,其大脑完成了一系列复杂的处理:其"认出"那是一个球(而不是一块石头或一团纸),其"判断"它的大小(约10厘米直径),其"预测"它可能的运动方式(如果滚动,它会往哪个方向),其"评估"它对行人的影响(行人需要绕开它吗?它会绊倒行人吗?)。
这一系列过程,才是真正的"看见"。
机器的感知,目标就是实现类似的"看懂"。但机器没有人类大脑中进化了几百万年的视觉皮层,它必须用人造传感器和算法来"模拟"这个过程。
目前,具身智能的感知系统主要依赖以下几类"人造感官":
摄像头(Camera),这是机器最常用的"眼睛"。它和人眼有一个根本的区别:人眼看到的是"立体"的(因为有两只眼睛,大脑可以通过视差计算深度),而普通的单目摄像头只能拍摄"平面"的二维图像。这就好比单眼视觉——可见物体的形状和颜色,但难以准确判断其距离。为了解决这个问题,工程师们发明了双目摄像头(模仿人眼的双眼视差)、深度摄像头(主动发射红外光来测距)等。
激光雷达(Light Detection and Ranging, LiDAR),这相当于机器的"蝙蝠技能"。蝙蝠通过发射超声波并接收回波来判断障碍物的位置和距离。激光雷达的原理类似,只不过它发射的是激光束。激光雷达的输出不是图像,而是"点云"(Point Cloud)——三维空间中的无数个点,每个点代表激光击中的物体表面的位置。这些点连起来,就构成了环境的"数字骨架"。激光雷达的优势是测距非常精确(误差可以控制在几厘米以内),而且不受光照影响——白天能用,黑夜也能用。缺点是成本较高(虽然价格一直在下降),而且在雨雾天气中性能受限(激光束会被水滴散射)。
毫米波雷达(Millimeter-wave Radar),这相当于机器的"穿山甲技能"。穿山甲能在黑暗中探测到蚂蚁窝的位置,靠的是敏锐的嗅觉和触觉。毫米波雷达发射的是毫米级波长的电磁波,可以穿透雨雾、雾霾,甚至在一定程度上穿透墙壁。它的优势是能够在恶劣天气中工作,而且能直接测量物体的相对速度(利用多普勒效应)。缺点是分辨率比较低——它能告诉你"前方50米有一辆车",但无法告诉你"那是一辆红色的小轿车,车牌号是……"
惯性测量单元(Inertial Measurement Unit, IMU),这相当于机器的"内耳"。人类的内耳中有前庭系统,负责感知身体的加速度和旋转,帮助我们保持平衡。IMU就是机器的"内耳",它包含加速度计和陀螺仪,可以感知机器的加速度、角速度和姿态变化。你的手机里就有一个IMU——当你把手机从竖屏转到横屏时,屏幕会自动旋转,就是IMU在起作用。
超声波传感器(Ultrasonic Sensor),这相当于机器的"海豚技能"。海豚通过发射超声波并接收回波来探测水中的障碍物和猎物。超声波传感器原理相同,发射高频声波并测量回波时间。它成本极低、结构简单,但有效距离较短(通常只有几米),分辨率也有限。在自动驾驶中,超声波传感器常被安装在保险杠上,用于近距离泊车辅助——当你倒车时听到的"滴滴"警报声,就是超声波传感器在告诉你"后面有东西,越来越近了"。
全球导航卫星系统(Global Navigation Satellite System, GNSS,包括GPS和北斗),这相当于机器的"方向感"。人类通过太阳的位置、地标建筑、甚至身体对地磁场的微弱感知(虽然这种感知很弱)来判断方向。GNSS则通过接收多颗卫星的信号,精确计算出接收器在地球上的位置(精度可达米级甚至厘米级)。对于自动驾驶汽车来说,GNSS告诉它"我在哪里",这是规划路线的基础。但GNSS也有局限——在高楼林立的"城市峡谷"中,卫星信号被遮挡,定位会漂移;在隧道和地下停车场中,GNSS完全失效。所以自动驾驶不能只依赖GNSS,必须结合其他传感器来"确认"自己的位置。
这些传感器各自有不同的优势和局限,就像人类五感各有分工一样。如果你蒙上眼睛,你还能靠听觉和触觉来判断环境;如果你堵住耳朵,你还能靠视觉来导航。具身智能的"人造感官"也需要这种"冗余设计"——当一种传感器失效时,其他传感器可以"补位"。这种"多传感器融合"(Multi-sensor Fusion)的策略,我们将在第2章详细探讨。
1.3.2 认知(Cognition):大脑的"加工"
感知提供了"原材料",但原材料本身不是智能。你不可能把一堆传感器数据扔给机器,然后期待它自动"明白"该怎么做。认知(Cognition),就是把这些原材料加工成"有意义的信息"的过程。
还是用生活中的例子。假设你正在开车,前方车辆的刹车灯突然亮了。在这一瞬间,你的大脑完成了什么?
你可能根本没有"思考"——你的脚已经自动移到了刹车踏板上。这就是认知的神奇之处:在熟练的驾驶中,大量的认知过程是在"潜意识"层面完成的。你的大脑"识别"出了刹车灯的含义(前车减速),"预测"了可能的后果(如果不减速,可能追尾),"决策"了行动方案(踩刹车),然后"执行"了动作——所有这些,发生在几百毫秒之内,你甚至可能意识不到自己"思考"了什么。
机器的认知,就是要模拟这个"从感知到决策"的加工过程。它包括:
目标检测(Object Detection):在传感器数据中"找到"物体——"那里有辆车""那边有个行人"。这是认知的第一步。
语义分割(Semantic Segmentation):不仅要"找到"物体,还要"理解"场景——"这是可行驶区域""那是人行道""这是车道线"。
预测建模(Predictive Modeling):基于当前状态,预测未来可能发生的事情——"那个行人可能要过马路""那辆车可能要变道"。
因果推理(Causal Reasoning):理解"为什么"——"因为信号灯变红了,所以前面的车停了下来""因为路面有积水,所以需要减速"。
认知是具身智能最核心、也最具挑战性的环节。它决定了机器是否能从"看见"进化到"看懂",从"反应"进化到"预判"。
这里需要特别强调一个关键的区别。传统的人工智能研究(也就是AlphaGo所代表的那条路线)把"认知"理解为"符号运算"——输入数据、处理数据、输出结果。这种认知是"离身的",与物理世界没有直接关系。但在具身智能中,认知是"嵌入的"(Embedded)——它不是在大脑的"真空"中进行的,而是发生在特定的身体中、特定的环境中、特定的任务中。
举个例子:一个自动驾驶系统在拥堵的城市道路上行驶,和它在空旷的高速公路上行驶,使用的"认知策略"可能完全不同。在城市道路上,它需要频繁地进行"社交推理"——判断旁边那辆车是不是想插队、那个行人是不是要闯红灯。在高速公路上,它更关注"物理规律"——前车的减速幅度、后车的跟车距离。同一个"大脑"(算法),在不同的"身体-环境"组合中,表现出不同的"认知风格"。这就是具身认知的精髓:认知不是大脑里的"固定程序",而是身体与环境交互时"实时生成"的。
我们将在第3章深入探讨这个话题。
1.3.3 行动(Action):身体的"输出"
感知是"输入",认知是"加工",行动(Action)就是"输出"。但行动不是简单的"运动"——不是机器"动了"就算行动,而是机器"有目的地、有意义地与物理世界交互"才算行动。
以一个日常案例说明来说明。
假设你正在伸手去接一杯水。这个动作看起来简单至极——你每天都在做,几乎从不会失手。但如果把它拆解开来,你会发现其中蕴含了惊人的复杂性:
你的大脑首先要估算杯子的距离(约30厘米远)、高度(约与肩膀齐平)、重量(大概200毫升,约200克重)。然后,它要规划手臂的运动轨迹——不能太快(会打翻水),也不能太慢(水会凉)。在手臂伸出的过程中,你的视觉系统持续跟踪杯子的位置,手指的触觉系统感知杯子的温度和材质。当你的手指触碰到杯子时,大脑立即调整手指的力度——太松了会滑落,太紧了会捏坏纸杯。最后,手臂将水平稳地收回,送到嘴边。
这一系列动作涉及了数十块肌肉的协调运动、多个感官系统的实时反馈、以及大脑中多个区域的协同工作。但你几乎意识不到这些计算——它已经变成了一种"自动化"的技能。
机器的行动,就是要实现类似的"自动化技能"。它包括:
电机控制(Motor Control):精确控制电机输出的力矩和速度,实现平稳、准确的运动。
轨迹规划(Trajectory Planning):在空间中规划一条从起点到终点的最优路径,避开障碍物,满足各种约束条件。
力矩调节(Torque Regulation):在与环境交互时,根据接触力的反馈实时调整输出的力度。
反馈修正(Feedback Correction):当行动的结果与预期不符时(比如没抓住杯子),及时调整策略。
机器的行动与人类行动有一个根本的区别:人类的很多行动是"自动化的"——你不需要"思考"怎么走路、怎么拿筷子,这些技能在你的身体里"沉淀"成了本能。但机器没有这种"本能"。它的每一个动作都需要被精确地计算和控制。一个微小的误差——比如电机输出的力矩大了千分之一——都可能导致整个行动的失败。
这就是为什么机器的行动控制如此具有挑战性。工程师们需要在"精确性"和"鲁棒性"(Robustness)之间找到平衡:一方面,机器的动作要足够精确,才能完成精细的操作(比如抓取一个易碎的鸡蛋);另一方面,机器的动作要足够鲁棒,能够应对环境中的不确定性(比如地面不平、负载变化、外力干扰)。
此外,机器的行动还受到"物理极限"的约束。电机有最大转速和最大扭矩,电池有最大输出功率,材料有最大承受力。这些"硬约束"就像给机器戴上了"镣铐"——好的具身智能系统不是"突破"这些镣铐,而是学会"戴着镣铐跳舞",在约束中找到最优的解决方案。
我们将在第4章详细探讨机器的行动与控制。
1.3.4 PCA闭环:三位一体的动态耦合
以下将感知、认知、行动三者进行综合阐述。
传统的思维方式是"流水线":先感知,再认知,再行动——就像工厂的流水线上,第一个工位拧螺丝,第二个工位装零件,第三个工位质检。这种模型看起来很合理,但它忽略了一个关键事实:感知、认知和行动不是三个独立的步骤,而是一个循环往复、相互塑造的动态系统。
以自行车学习过程为例说明。
还记得你第一次骑自行车的感觉吗?车身摇摇晃晃,你紧张得手心冒汗。突然,车身向左倾斜——这是感知(你的身体感觉到了失衡)。你的大脑瞬间"意识到"要摔倒了——这是认知。你下意识地把车把向右转——这是行动。车身回正了一些,但马上又向右倾斜——新的感知。你的大脑再次"判断"需要调整——新的认知。你再次转动车把——新的行动。如此循环往复,直到你找到了那个"平衡点"。
注意这个过程中最关键的一点:行动改变了环境,环境的变化又产生了新的感知,新的感知引发了新的认知,新的认知指导了新的行动。 这不是一条直线,而是一个螺旋上升的圆环。每一次循环,你的"技能"都在提升——你的身体在"学习"如何保持平衡。
这就是PCA闭环(Perception-Cognition-Action Loop)。它是具身智能的核心机制,也是本书的主线。
以下对PCA闭环进行系统化阐述。这个闭环之所以强大,是因为它具有三个关键特征:
第一个特征是实时性(Real-time)。 PCA闭环不是"先感知完所有信息,再统一思考,最后一次性行动",而是在时间轴上持续不断地运转。自动驾驶汽车在行驶过程中,传感器以每秒30帧甚至更高的频率采集数据,算法以毫秒级的延迟做出决策,执行器以微秒级的响应时间调整车辆状态。这种实时性让具身智能能够对快速变化的环境做出及时反应——就像你骑自行车时,如果等身体完全倾斜了才去调整,你早就摔倒了。
第二个特征是耦合性(Coupling)。 感知、认知和行动三者不是独立的模块,而是紧密耦合在一起的。感知不是"被动地接收信息",而是"主动地探索环境"——机器会转动摄像头、调整传感器参数来获取更有价值的数据。认知不是"纯粹地推理",而是"受行动目标驱动的"——机器只处理与当前任务相关的信息。行动不是"机械地执行指令",而是"持续感知效果的"——机器会根据行动的结果来评估认知的正确性。三者你中有我、我中有你,形成了一个不可分割的整体。
第三个特征是学习性(Learning)。 每一次PCA闭环的运转都会产生一个结果——成功或失败。这个结果被用来"更新"系统的内部模型,使得下一次运转更加"聪明"。自行车学习者正是在无数次"失衡→调整→恢复"的循环中,逐渐掌握了平衡的"感觉"。自动驾驶系统也是在数百万公里的行驶中,不断从"预测对了"和"预测错了"的经验中学习,逐渐提高决策的准确性。这种"从经验中学习"的能力,是PCA闭环区别于传统"预编程控制"(Pre-programmed Control)的根本所在。
在自动驾驶中,PCA闭环是这样运转的:
感知层:摄像头、激光雷达、毫米波雷达同时工作,实时采集道路环境数据——"前方100米处有一辆货车""右侧车道有一辆小轿车正在靠近""前方50米处有一个行人站在路边"。
认知层:算法大脑对这些数据进行处理——"货车正在以80km/h的速度行驶,与我车的距离正在缩短,需要保持安全车距""右侧小轿车正在变道,我需要减速让它并入""路边的行人没有过马路的迹象,暂时不需要减速,但需要保持警惕"。
行动层:根据认知结果,系统控制车辆的油门、刹车和方向盘——"适当松开油门,保持当前车道""轻踩刹车,降低车速""双手保持在方向盘上,准备随时制动"。
然后,新的传感器数据不断涌入,新的认知不断更新,新的行动不断调整——闭环持续运转。
这个闭环的核心价值在于:它不是预先编程好的"如果A则B"的规则列表,而是一个不断学习、不断进化的动态系统。 每一次与环境的交互,都会让这个闭环变得更加"聪明"。
这就是具身智能的"生长"方式——不是通过死记硬背规则,而是通过与世界的真实交互来"长"出智能。
1.4 具身智能的"物种图谱"
具身智能不是一个单一的技术,而是一个"大家族"。不同的具身智能体,拥有不同的"身体",适应不同的环境,解决不同的问题。以下介绍该家族的主要成员。
1.4.1 人形机器人:向人类"看齐"
人形机器人是具身智能家族中最"像人"的一员。它们有两条腿、两条胳膊、一个脑袋,试图模仿人类的身体结构和运动方式。
为什么偏偏是人形?这不是因为工程师们对"人类"有什么执念,而是一个非常务实的考虑:人类世界的基础设施是为人类的身体设计的。 门把手的高度、楼梯的台阶间距、工具的握持方式——这些都是按照人类的人体工程学设计的。如果一个人形机器人能够像人一样使用这些设施,它就能无缝地融入人类环境,而不需要为机器人重新设计一套基础设施。
目前,人形机器人领域的主要玩家包括:
波士顿动力Atlas:前面提到的"后空翻明星"。56个自由度、全电动驱动、强化学习运动控制。2026年已获得现代汽车3万台订单,计划2028年投入汽车工厂。〔54〕
Figure 02:美国初创公司Figure AI的产品,身高约1.7米,主打"通用人形工人"概念,可以在仓库中搬运箱子、在工厂中操作设备。
宇树H1:中国宇树科技的产品,主打高性价比,已在一些科研机构和商业场景中落地。
智元远征A1:中国智元机器人的产品,强调人工智能大模型(Large Language Model, LLM)与机器人硬件的深度融合。
特斯拉Optimus:依托特斯拉在自动驾驶领域积累的技术(视觉感知、神经网络、电机控制), Optimus的目标是用"造车的思路"来"造人"。4
1.4.2 自动驾驶汽车:"轮式机器人"
如果你问"目前最成功的具身智能应用是什么",答案很可能是:自动驾驶汽车。
自动驾驶汽车本质上就是一个"轮式机器人"——它有传感器(摄像头、激光雷达、毫米波雷达)、有大脑(自动驾驶算法)、有执行器(转向电机、制动系统、驱动电机)、有与物理世界的持续交互(在真实道路上行驶)。它完全符合具身智能的定义。
而且,自动驾驶是具身智能领域中商业化程度最高的方向。特斯拉的FSD(Full Self-Driving)系统已经在北美积累了数十亿英里的行驶数据。4 华为ADS、小鹏XNGP、蔚来NOP等中国厂商的自动驾驶系统,也在快速迭代。2025年,L3级(有条件自动驾驶)在多个国家和地区获得法规批准,标志着自动驾驶正式进入"量产时代"。4
自动驾驶之所以成为具身智能的"排头兵",有几个原因:第一,道路环境虽然复杂,但相比城市街道、家庭室内等环境,还是相对结构化的——有车道线、有交通信号灯、有交通规则。第二,汽车本身就是一个"成熟平台"——传感器、计算单元、执行器都可以集成在车上,不需要从头设计。第三,商业价值巨大——自动驾驶有望大幅降低交通事故率、提高交通效率、改变出行方式。
自动驾驶的PCA闭环每天都在真实世界中运转数十亿次。每一辆上路的自动驾驶汽车,都在持续不断地感知周围环境、认知交通状况、执行驾驶操作——这是一个运转中的、活生生的具身智能系统。而且,当一辆自动驾驶汽车在某个罕见场景中"学会"了如何处理,这个经验可以通过"车队学习"(Fleet Learning)分享给所有同型号的车辆。这不是简单的"数据复制",而是具身智能的"集体进化"——整个车队的PCA闭环在一起变得更加"聪明"。
1.4.3 四足/多足机器人:超越人类的"身体"
如果说人形机器人是在"模仿人类",那么四足机器人就是在"超越人类"。
波士顿动力的Spot是四足机器人的代表。它有四条腿,可以在崎岖不平的地形上行走、爬楼梯、跨越障碍物。它的"身体"比人类更适合某些环境——比如废墟搜救(可以钻进人类无法进入的狭窄空间)、管道巡检(可以在人类无法站立的管道中行走)、甚至外星球探测(NASA正在研究用四足机器人探索火星表面)。
中国的宇树Go2是另一款代表性的四足机器人,以其高性价比和开源生态受到了学术界和创客社区的欢迎。
多足机器人(如六足、八足)则更进一步——它们的步态更加稳定,即使几条腿受损,也能继续行走。这让人联想到昆虫的生存智慧:蟑螂可以在失去几条腿的情况下继续奔跑。
1.4.4 软体机器人与微型机器人:另类的"身体"
具身智能的"身体"不一定要有骨骼和关节。软体机器人(Soft Robotics)使用柔性材料(如硅胶、气动人工肌肉)来模拟生物体的运动方式。比如,模仿章鱼触手的软体机器人可以在狭窄的空间中伸展、抓取、缠绕,适应传统刚性机器人无法处理的环境。
微型机器人(Microrobot)则是在微观尺度上工作的具身智能体。它们可以进入人体血管进行药物输送、在精密仪器内部进行检测维修、在农业领域进行精准授粉。它们的"身体"只有几毫米甚至几微米大,但同样遵循感知-认知-行动的闭环逻辑。
这些"另类"的具身智能体提醒我们一个重要的事实:智能的形态是多样的,身体的形态也应该是多样的。 不一定非要"像人"才能"有智能"。海星没有大脑,但它能灵活地移动和觅食;植物没有神经系统,但它们能"感知"阳光的方向并调整叶片的朝向。智能和身体的耦合方式,远比我们想象的更加丰富。
一个值得探讨的思考实验:假设外星文明派出探测器来到地球,看到了三种"智能体":人类、自动驾驶汽车和章鱼。如果外星人试图总结"智能的普遍规律",他们会发现什么?人类用两条腿走路,用两只眼睛看世界,用十根手指操作工具;自动驾驶汽车用四个轮子行驶,用摄像头和雷达感知环境,用电机控制方向;章鱼用八条触手爬行,用全身的皮肤"看见"光线和颜色,用喷射水流的方式移动。三种完全不同的"身体",三种完全不同的"感知-认知-行动"方式,但都展现出了适应环境的"智能"。
这个思考实验揭示了一个重要原理:具身智能的研究不能局限于"让机器像人一样"。真正的挑战是理解"身体如何塑造智能"这个更普遍的规律——无论是人类的身体、汽车的身体、章鱼的身体,还是某种我们尚未发明的全新身体。每一种身体都有其独特的"认知世界",都有其独特的"与世界交互"的方式。具身智能的终极目标,不是"复制人类",而是"理解智能的本质"——而身体,正是通往这个本质的钥匙。
1.5 本章小结:从概念到认知的进阶
本章核心内容总结如下。
我们从两个具有全球影响力的事件开始——AlphaGo在围棋上的"遗憾"和Atlas在物理世界中的"后空翻"。这两个故事告诉我们:智能的完整形态,既需要"大脑",也需要"身体"。
然后我们走进了哲学的殿堂,了解了具身认知的三大命题——身体结构规定认知能力范围、身体结构决定认知产生机理、身体-认知-环境组成动态统一体。这些看似抽象的哲学命题,其实每天都在你的生活中上演:你微笑的时候会觉得更开心,你身体前倾的时候会对积极的事物反应更快,你骑自行车时的平衡感是你的整个身体在与自行车和路面的交互中"长"出来的。
接着我们建立了具身智能的系统观——感知(Perception,世界的入口)、认知(Cognition,大脑的加工)、行动(Action,身体的输出),以及三者构成的PCA闭环(Perception-Cognition-Action Loop)。这个闭环不是流水线,而是循环往复、相互塑造、不断进化的动态耦合系统。
最后我们浏览了具身智能的"物种图谱"——从人形机器人到自动驾驶汽车,从四足机器人到软体机器人。它们有不同的身体,但遵循同样的逻辑:通过身体与环境的交互,在PCA闭环中"生长"出智能。
通过本章的学习,读者已经建立了具身智能的入门级概念框架。
你不需要懂数学公式,不需要会写代码,不需要知道卷积神经网络(Convolutional Neural Network, CNN)的内部结构。你只需要记住一个核心思想:身体决定心智,交互产生智能。
这个简单的思想,将贯穿整本书的每一个章节。从哲学的角度看,它呼应了梅洛-庞蒂的"现象身体"(Phenomenal Body)和具身认知的三大命题;从工程的角度看,它解释了为什么具身智能正在成为人工智能发展的主流方向;从教育的角度看,它提醒我们:学习不是"往大脑里灌输知识",而是"让身体与世界交互并从中获得经验"。
2025年中国自动化学会科普大讲堂上的一个核心观点是:"教学的核心不是教书本上的旧知识,而是向学生展示如何离开自己的舒适区,从头开始学习并应用一项新知识、新技术。"这句话深刻地诠释了具身智能的教育哲学——不是"灌输",而是"启发";不是"复制",而是"创造";不是"知道",而是"做到"。
在接下来的章节中,我们将拆开机器的身体,逐一审视它的"感官"是如何工作的(第2章),它的"大脑"是如何决策的(第3章),它的"四肢"是如何行动的(第4章)。然后,我们将走进虚拟世界,审视机器是如何在"平行宇宙"中学习和成长的(第5、6章)。最后,我们将一起思考:在这个智能时代,人类应该扮演什么样的角色(第7章)。
以下进入下一章内容。
【实验一】走进虚拟仿真实验室——认识第一台具身智能实验车
聚焦问题:如何用一台电脑、一套软件,在虚拟世界中"造"出一辆会自动驾驶的微缩智能车?
实验目标
了解微缩智能车虚拟样机和虚拟赛道的实现手段
理解"虚拟仿真"作为具身智能研究工具的优势和不足
建立本地微缩智能车自动驾驶虚拟仿真实验室(安装CarLab+CarCode)
建立"虚拟世界中的具身智能体"的直观认知
实验内容与步骤
步骤1:虚拟场景是怎么来的?(10分钟)
微缩智能车自动驾驶竞赛原本是物理世界的赛事——真实的微缩智能车在真实的赛道上竞速。但通过虚拟样机技术(Virtual Prototyping),这一赛事被完整地"搬"进了电脑。中国大学生智能汽车竞赛的赛道被1:1还原为虚拟仿真环境,赛道的每一处弯道、每一段直路、每一个坡度都与真实赛道完全一致。现在,请进入实验指导视频,观看"微缩智能车自动驾驶虚拟场景怎么来",然后思考并回答:
物理世界的微缩智能车比赛任务,是如何通过虚拟样机技术转化为仿真任务的?
虚拟仿真有什么优势?有什么不足?
你还能想到哪些改进思路?
本章知识链接:回想本章1.4节中提到的"具身智能物种图谱"——微缩智能车正是"轮式机器人"的一种。它也有"身体"(底盘+车轮+摄像头)、有"感官"(摄像头采集图像)、有"大脑"(算法处理图像并输出控制指令)、有"行动"(电机驱动车轮转向和行驶)。它完全符合具身智能的定义。
步骤2:建立本地虚拟仿真实验室(15分钟)
你需要安装配置以下软件环境:
下载并解压ROAD50.exe插件:这是虚拟赛道的图形渲染插件,提供了1:1还原的虚拟赛道环境
安装Python 3.6.8:实验指定的Python版本,确保与后续代码兼容
安装PyCharm Community Edition:Python的集成开发环境(Integrated Development Environment, IDE),用于编写和运行代码
安装必要的Python功能包:OpenCV(图像处理)、TensorFlow/Keras(深度学习)、NumPy(数值计算)等
实验环境包含两个核心文件夹:
CarLab文件夹:包含不同尺寸的虚拟样机(两种不同尺寸的智能车模型)和八个虚拟赛道(从简单直道到复杂障碍物赛道)的仿真平台。这就是你在虚拟世界中的"赛道"和"赛车"。
CarCode文件夹:包含操作控制虚拟小车的Python源代码。这就是虚拟小车的"大脑"——算法代码。
本章知识链接:CarLab是本章5.1节和5.2节将深入介绍的ACP方法论中的"人工系统(A)"——一个可计算、可实验的虚拟环境。CarCode则对应PCA闭环中的"认知+行动"模块——算法代码负责"理解"感知数据并"输出"控制指令。
实验报告
请回答以下问题:
虚拟小车和物理小车有什么相同之处?有什么不同之处?(从"身体""感官""大脑""行动"四个维度分析)
为什么要在虚拟世界中训练自动驾驶算法,而不是直接在真实世界中训练?结合本章AlphaGo和Atlas的故事来思考。
虚拟仿真最大的优势和最大的局限分别是什么?
专栏1-1 AlphaGo的"第78手"事件:一个业余错误的深层原因
在人机大战第四局的第78手之后,AlphaGo接连走出了黑79退、黑83靠、黑85等一系列"问题手"。据DeepMind团队后来的分析,AlphaGo在第79手时认为自己胜率高达70%,直到第87手左右才"意识到"自己犯了错误。〔72〕
职业棋手张东岳等人复盘后发现,黑79其实有更好的下法——在1位打,然后强硬挡住,白棋大龙求活无门。也就是说,AlphaGo的第79手并不是"最优解",而是一个"错误"。但这个错误本身也反映了深度学习的一个根本性局限:它学到的是统计相关性,而不是因果逻辑。 在面对训练数据中极少出现的"异常局面"时,它的判断会出现偏差。
李世石的第78手之所以被称为"神之一手",不仅因为它是一步好棋,更因为它击中了人工智能的"盲区"——那个统计规律覆盖不到的角落。
有趣的是,AlphaGo的这个"失误"后来促成了一个重要的研究方向:如何让AI在"不确定性"中做出更鲁棒的决策。2017年,DeepMind推出了AlphaGo Zero,它不再依赖人类棋谱,而是完全通过自我对弈从零开始学习。它在棋盘上表现出了更强的"直觉"和"创造力",甚至在某些局面下走出了人类棋手从未想到过的棋。这说明,通过扩大学习的"体验空间"(哪怕只是在虚拟的棋盘空间里),AI可以获得更强大的智能。这也为后来具身智能的发展提供了一个重要启示:智能的成长需要"经验",而经验来自于与环境的交互。
专栏1-2 如果你是一只蝙蝠
"成为一只蝙蝠会是什么样子?"
这是美国哲学家托马斯·内格尔(Thomas Nagel)在1974年发表的一篇著名论文的标题。蝙蝠通过超声波来"看见"世界——它们发射高频声波,然后通过接收回波来判断障碍物的位置和形状。蝙蝠的"世界"充满了回声的纹理、距离的节奏、运动的多普勒频移。这个"世界"对人类来说是不可想象的,因为我们没有蝙蝠的感官系统。
内格尔的核心观点是:主观体验与特定的身体结构密不可分。 你无法通过"想象"来理解蝙蝠的体验,因为你的大脑不是为超声波感知而设计的。同样,你也无法通过给AlphaGo添加更多的算力来让它"理解"骑自行车是什么感觉——因为它没有人类的身体。
这个思想实验对具身智能研究有深刻的启示。当我们设计具身智能体时,我们不仅在设计它的"大脑"(算法),也在设计它的"世界"(身体所感知的那个版本的世界)。一个人形机器人的"世界"是由摄像头像素、激光雷达点云和关节角度编码器构成的。一个四足机器人的"世界"是由地形起伏、脚接触力反馈和重心偏移构成的。这些"世界"与人类的世界截然不同——它们不是"劣化版"的人类世界,而是完全不同版本的世界。
理解这一点非常重要,因为它提醒我们:不要用人类的"认知标准"去评判机器的"智能"。当Atlas完成后空翻时,它"体验"到的不是人类运动员那种"肾上腺素飙升的快感",而是一种完全不同的东西——也许是关节力矩的最优分布、也许是重心轨迹的最小偏离。这种"体验"对人类来说毫无意义,但对Atlas来说,它就是"智能"的表现形式。
专栏1-3 具身智能 vs 离身智能对照表
| 维度 | 离身智能(Disembodied Intelligence,如AlphaGo) | 具身智能(Embodied Intelligence,如Atlas) |
|---|---|---|
| 是否有物理身体 | 否(纯软件) | 是(机器人硬件) |
| 是否与物理世界交互 | 否 | 是 |
| 感知来源 | 输入的数据(如棋谱) | 传感器(摄像头、雷达等) |
| 行动输出 | 符号(如下一步棋的位置) | 物理运动(如电机转动) |
| 学习方式 | 离线训练(Offline Training,学习已有数据) | 在线学习(Online Learning,与环境交互中迭代) |
| 智能范围 | 局限于特定任务(如下围棋) | 可迁移到多种任务(如行走、搬运) |
| 错误成本 | 低(下错棋可以重来) | 高(摔倒可能造成物理损坏) |
| 核心优势 | 特定任务上可超越人类 | 能适应开放、动态的物理世界 |
| 典型代表 | AlphaGo、ChatGPT、推荐系统 | 自动驾驶汽车、人形机器人、无人机 |
延伸阅读:从《西部世界》到《流浪地球》:科幻作品中的具身智能想象
在科幻作品中,具身智能的想象由来已久。美剧《西部世界》中,人造的"接待员"拥有与人类几乎无异的肉体,在主题公园中与游客互动——它们是最极致的"具身智能",连身体都是人造的。它们的皮肤有温度,眼睛会流泪,肌肉会疲劳。它们在与人类的互动中逐渐"觉醒"——开始质疑自己的存在、开始追求自由意志。这个设定触及了具身智能最核心的哲学命题:如果一个智能体拥有与人体几乎一样的身体,并在这个身体中积累了丰富的"人生经验",它是否就拥有了与人类一样的"意识"和"灵魂"?《西部世界》没有给出简单的答案,但它促使我们思考:身体的"相似性"是否是意识"等价性"的前提?
电影《流浪地球》中的MOSS则代表了另一个极端。它是一个没有身体的超级AI,被安装在国际空间站上,通过控制各种机械设备来影响物理世界——它操控着行星发动机的运行、监控着地球的状态、甚至做出了"放弃地球、保存人类文明火种"的决策。MOSS是"离身"的,但它却在"操控具身"。这个设定提出了一个有趣的问题:一个离身的超级智能,是否可以通过控制具身智能体来间接地"参与"物理世界?这是否是一种"间接具身化"(Indirect Embodiment)的具身智能?
在阿西莫夫的《我,机器人》中,机器人三大定律的设定也反映了具身智能的伦理困境。第一定律("机器人不得伤害人类")看似简单,但在复杂的现实情境中却产生了无数悖论。比如,如果一个机器人为了救五个人而必须牺牲一个人,它应该怎么做?这正是自动驾驶领域今天面临的"电车难题"(Trolley Problem)——我们将在第7章详细讨论。
这些科幻想象看似遥远,但很多正在变成现实。Atlas已经从实验室走向工厂,自动驾驶汽车已经在真实道路上行驶,人形机器人正在学习使用人类的工具。也许再过十年,我们会看到《西部世界》中的场景在某种程度上成为现实——不是那个黑暗的结局,而是人机共生的美好图景。
如果对科幻中的具身智能想象感兴趣,以下几部作品值得推荐:菲利普·迪克的小说《仿生人会梦见电子羊吗?》(电影《银翼杀手》的原著),它探讨了"人造身体"与"人性"的边界;石黑一雄的《克拉拉与太阳》,讲述了一个具有"情感感知能力"的人工智能玩偶的故事;以及特德·姜的短篇小说《你一生的故事》,它从语言学和物理学的角度,探讨了拥有不同"身体"和"感知方式"的智能如何理解世界。
本章互动
2 条读者反馈- 文学院 王同学建议待处理
希望 AlphaGo 与 Atlas 两个案例各配一张示意图,纯文字对文科生略有门槛。